
声浪

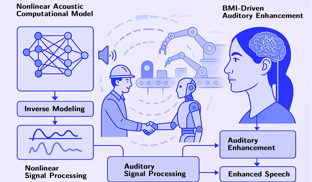
非线性声学计算与强化学习融合框架:突破复杂环境人机交互的新技术

随着人工智能的快速发展,尤其是在深度学习和强化学习领域,声学计算和人机交互进入前所未有的扩展和创新阶段。尽管传统声学方法取得了显著成功,但这些线性或准线性方法在实际环境中往往存在关键的不足,尤其在动态、复杂或混响环境中,远场语音处理、弱声信…
17 0 0
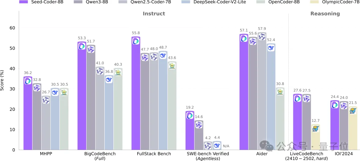
字节Seed首次开源代码模型,拿下同规模多个SOTA,提出用小模型管理数据范式
量子位 | 公众号 QbitAI 字节Seed首次开源代码模型!Seed-Coder,8B规模,超越Qwen3,拿下多个SOTA。 它证明“只需极少人工参与,LLM就能自行管理代码训练数据”。通过自身生成和筛选高质量训练数据,可大幅提升模型…
20 0 0
Voila:开源端到端 AI 语音模型,195ms低延迟引领全双工对话!
Maitrix 团队最新发布的开源 AI 端到端语音模型: Voila,该模型采用创新的分层Transformer架构,突破传统语音AI限制,实现195ms超低延迟实时交互,支持高度个性化定制,并在语音识别、合成及多语言翻译等任务中表现卓越…
37 0 0
CCF语音对话与听觉专委会论文导读(2025年第2期)
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享七篇发表在ICASSP2025上的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见…
16 0 0
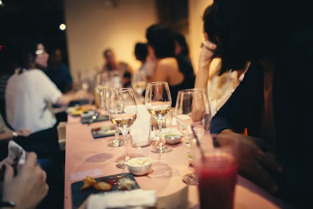
波士顿大学新算法攻克 “鸡尾酒会问题”,听力损失者福音
当一群朋友在酒吧相聚,或是围坐在一起享用私密晚餐时,谈话声会迅速增多并交织在一起,不同的小群体和两两组合的人们相互交谈着,声音此起彼伏。 对于有听力损失的人来说,在这热闹嘈杂的话语声中辨别方向,并专注于重要的内容尤其困难。热闹的交谈声可能会…
21 0 0
英伟达开源语音识别模型!0.6B 参数登顶 ASR 榜单,1 秒转录 60 分钟音频!
英伟达在5月1日发布了一款开源语音识别模型:Parakeet TDT 0.6B V2,其以 600M 参数登顶 Hugging Face Open ASR 榜单。 项目链接:
30 0 0