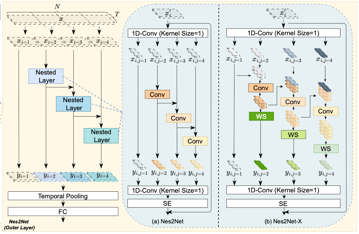
Nes2Net:轻量级嵌套架构,驱动基于语音大模型的深度伪造检测

随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…
24 0 0

随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…

近日,上海人工智能实验室(上海 AI 实验室)开源了生成式世界模型 AETHER。该模型全部由合成数据训练而成,不仅在传统重建与生成任务中表现领先,更首次赋予大模型在真实世界中的 3D 空间决策与规划能力,可助力机器人完成目标导向的视觉规划…
TytoCare作为虚拟护理领域的创新企业,专注于为家庭环境提供高效的基础医疗服务。近日,该公司取得重要突破——其Tyto Insights™系统的哮鸣音检测功能获得FDA批准,这意味着TytoCare成为全球首家实现AI技术全面检测三种主…
今天分享一个声音克隆及语音合成系统——MegaTTS3 MegaTTS3 是由字节跳动与浙江大学联合推出的开源语音合成工具,主模型仅有 0.45B 参数,具备高度轻量化优势。支持超高质量的语音克隆,能在 Huggingface Demo 体…
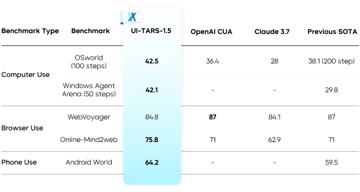
昨天字节开源多模态智能体 UI-TARS-1.5,这是一款基于视觉-语言模型构建的开源多模态智能体,能够在虚拟世界中高效执行各类任务。 GitHub:https://github.com/bytedance/UI-TARS Website:…

来源丨21db声学人 在当今这个日益互联互通的世界里,语言学习对于教育、商业以及文化交流而言已变得至关重要。然而,准确衡量语言学习者的熟练程度是一个复杂的问题。一种有价值的方法是让学习者听句子,然后尽可能准确地重复出来,这种方法被称为 “诱…


智能语音交互领域,学术研究也能如此酷炫。全球首个纯学术界自研的支持多人实时口语对话的语音情感大模型 ——“交交”,正式推出! “交交” 由上海交通大学听觉认知与计算声学实验室倾力打造,它不仅是一个智能语音助手,更是一个多说话人、多语言、多角…
