

声浪


英伟达神秘视频基础模型「Cosmos」曝光,数据全靠偷

来源丨机器之心 为了这个视频模型,英伟达每天正在疯狂地爬取相当于 80 年时长的视频数据。 今天,一则关于英伟达要下场做视频模型的消息引爆了 Reddit。 消息源出自外媒 404 Media,据它获得的 Slack 聊天(英伟达的内部聊天…
13 0 0

比OpenAI的Whisper快50%,最新开源语音模型
生成式AI初创公司aiOla在官网开源了最新语音模型Whisper-Medusa,推理效率比OpenAI开源的Whisper快50%。 aiOla在Whisper的架构之上进行了修改采用了“多头注意力”机制的并行计算方法,允许模型在每个推理…
17 0 0

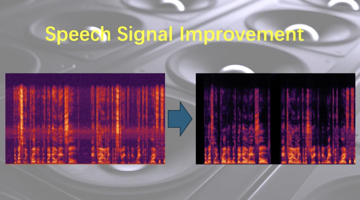
INTERSPEECH2024 | RaD-Net 2:基于因果性蒸馏和复数轴向自注意力机制的两阶段音质修复模型

随着手机、笔记本电脑等智能设备的普及,音频通信系统在人们的日常生活中起到了越来越重要的作用。然而,受硬件等多种因素的限制,通信系统中的语音信号经常因频率响应失真、不连续失真、响度问题、混响和噪声等受到损伤,影响听感。在ICASSP 2024…
5 0 0

媲美GPT-4o!复旦推出语音模型 SpeechGPT2
SpeechGPT2 是由复旦大学计算机学院开发的一个端到端的语音对话语言模型,类似于 GPT-4o。能够感知并表达情感,并根据上下文和人类指令以多种风格提供合适的语音响应。如说唱、戏剧、机器人、搞笑和低语等。 项目地址:https://0…
13 0 0


Sensors专刊征稿: “自动语音识别,音频和水下声学信号分析的进展”,欢迎投稿!
链接:https://www.mdpi.com/journal/sensors/special_issues/4PJ45YQ956 机器学习技术与声学的交汇开启了信号处理创新的新时代。本期特刊“自动语音识别、音频和水下声学信号分析的进展”致…
20 0 0

IEEE SPL | MMGER:利用大语言模型改进口音和语音识别的多模态多粒度生成式错误纠正方法
语音识别(ASR)作为可以准确高效转录语音的技术,已经取得了长足进步。但是当遇到口音等特殊语音条件时,识别错误率急剧攀升。语言模型(LM)可以利用ASR产生的假设(hypothesis)完成错误纠正。最近的一些工作利用大语言模型(LLM)卓…
10 0 0

开源发布RAG-CoT:一项结合检索增强生成(RAG)和思维链(CoT)的经验研究
论文地址:https://arxiv.org/abs/2407.15569 开源代码及模型:https://github.com/thu-spmi/RAG-CoT
7 0 0