EchoFree—超轻量神经声学回声消除模型

声学回声消除(Acoustic Echo Cancellation, AEC) 作为语音通信系统的核心预处理模块,其核心任务是从麦克风采集信号中实时分离近端语音(near-end speech)与远端回声(far-end echo)。该技术…
21 0 0

声学回声消除(Acoustic Echo Cancellation, AEC) 作为语音通信系统的核心预处理模块,其核心任务是从麦克风采集信号中实时分离近端语音(near-end speech)与远端回声(far-end echo)。该技术…
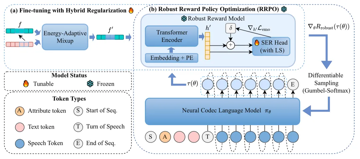
标题:《RRPO: Robust Reward Policy Optimization for LLM-Based Emotional TTS》 链接:https://arxiv.org/pdf/2512.04552 作者单位:阿里通义实验…
语音识别(ASR)作为高效转录语音的技术,在当今社会中扮演着越来越重要的角色。借助大语言模型的语音识别(LLM-ASR)性能出色,但通常会产生高昂的计算成本。探索LLM-ASR的高效训练策略以及扩展方法具有重要意义,以便获得给定计算成本(F…
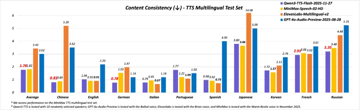
最近 TTS 领域是真的越来越卷了,国内外各个互联网大厂轮番上阵。 阿里通义(Qwen)团队最近在开源界简直是“劳模”级别的存在,这边又悄悄上新了全新的Qwen3-TTS。 而且一出手就明显是冲着「自然度 + 多音色 + 多语言」这一代标准…
这篇论文主要想解决全双工口语对话系统(SDS)的核心难题——怎么让系统同时“听、说、思考”还不混乱,重点提出了一个“语义 VAD”当对话管理器(DM),用轻量级 LLM 搞定轮次切换,平衡了交互流畅度和计算效率。 原文链接:https://…
作为语音相关研究领域的旗舰国际会议,ASRU2025(IEEE Workshop on Automatic Speech Recognition and Understanding)将于12月6-10日在夏威夷檀香山举办。IEEE ASRU…
论文题目:《SpeakerLM: End-to-End Versatile Speaker Diarization and Recognition with Multimodal Large Language Models》 论文地址:ht…
