
语音 AI 公司 Deepgram 发布 Saga,面向开发者的语音操作系统

总部位于加利福尼亚州旧金山的语音人工智能平台 Deepgram 宣布推出 Deepgram Saga,这是一款专为开发者设计的语音操作系统,旨在消除现代开发中频繁切换工具、寻找信息的「隐形税」,让开发者能够专注于构建,而非琐碎的操作。Sag…
23 0 0

总部位于加利福尼亚州旧金山的语音人工智能平台 Deepgram 宣布推出 Deepgram Saga,这是一款专为开发者设计的语音操作系统,旨在消除现代开发中频繁切换工具、寻找信息的「隐形税」,让开发者能够专注于构建,而非琐碎的操作。Sag…

当语音大语言模型(SLLM)在英语等核心语言中流畅执行语音指令时,日语、法语等非核心语言场景却因语音 - 文本配对的指令跟随数据稀缺与多语言推理能力局限,面临响应质量显著下降的挑战。传统跨语言方法多聚焦文本领域,而 SLLM 以语音信号为输…


近年来,文本转语音(TTS)技术在影视配音、虚拟助手等领域需求激增,而高自然度和控制能力成为关键。而能将 TTS 技术做到“影视级”水准的,即使在全球范围内也是屈指可数。 但近日,B站语音团队推出了全新一代语音合成模型:IndexTTS2,…


歌唱语音合成(SVS)的快速发展亟需高质量标注数据集,但传统人工标注成本高昂且效率低下。现有自动歌唱标注(ASA)方法通常仅解决标注流程中的孤立任务。为此,我们提出STARS,首个统一框架,同时解决歌唱转录、歌词对齐与精细化风格标注三大任务…

紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…

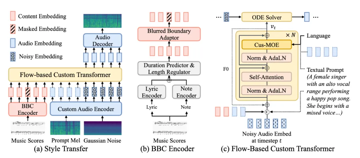
零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…

近年来,神经网络偏置(Deep Biasing)方法在上下文语音识别(Contextual ASR)任务中取得了显著进展,其旨在提升模型对实体名称、技术术语等罕见短语的识别能力。当前主流方法多基于浅融合或神经网络偏置技术,将上下文短语中的子…
