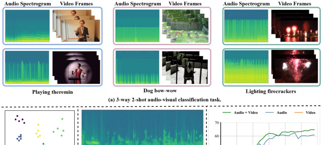
TASLP 2026 | 仅需少量样本,让AI“听音观像”:语义调制提示学习框架 SMP

小样本视听分类(Few-Shot Audio-Visual Classification, FS-AVC)是多模态学习领域极具挑战性的任务。它要求模型在仅有极少量标注样本的情况下,通过挖掘视觉与听觉的互补信息,实现对新类别的准确识别。 然而…
23 0 0

小样本视听分类(Few-Shot Audio-Visual Classification, FS-AVC)是多模态学习领域极具挑战性的任务。它要求模型在仅有极少量标注样本的情况下,通过挖掘视觉与听觉的互补信息,实现对新类别的准确识别。 然而…

来源丨新智元 2026年1月8日,智谱登陆港交所,成为全球首家以AGI基座模型为核心业务的上市公司。凭借GLM技术与MaaS商业化增长,它以「全球大模型第一股」的稀缺性吸引顶级资本加持,也标志着中国AGI企业正式走向资本市场舞台中央。 20…

来源丨新智元 文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维…

先说我的观点 如今市面上有很多类似的产品,大部分通过串联不同 API 来实现与不同形态机器的对话。这是一个已经形成多年共识的方向,也代表了人们对 AI 的终极想象——希望它能真正像人一样与我们对话。 既然如此,为什么不去开发交互能力强、能说…


来源丨机器之心、具身智能大讲堂 Gen Robot.AI团队在Hugging Face平台公开了10Kh RealOmni-Open数据集,该数据集累计包含超10000小时数据、100万+任务剪辑,存储总量达95TB,是当前行业内规模领先的…

近年来,基于大语言模型(LLM)的零样本文本转语音(Zero-shot TTS)系统发展迅速,已经能够在仅提供几秒参考音频的情况下,合成自然、清晰、且具有说话人风格的语音。然而,即便是最先进的系统,在真实使用场景中仍然频繁出现一些“局部灾难…

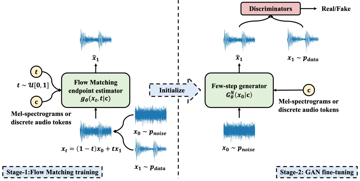
新一代 Kaldi 团队近日开源了一个自研音频生成模型(声码器)Flow2GAN,质量高、速度快、好训练,是 BigVGAN 一个不错的替代方案,欢迎体验。 论文:Flow2GAN: Hybrid Flow Matching and GAN…
