声浪

Google 开源面向医学的语音识别 MedASR,专用开源模型的春天来了?

官方 Blog: https://developers.google.com/health-ai-developer-foundations/medasr huggingface: https://huggingface.co/google…
20 0 0
智谱GLM-4.7上线并开源,代码能力超越GPT-5
GLM-4.7上线并开源。新版本面向Coding场景强化了编码能力、长程任务规划与工具协同,并在多项主流公开基准测试中取得开源模型中的领先表现。 目前,GLM-4.7已通过BigModel.cn提供API,并在z.ai全栈开发模式中上线Sk…
16 0 0
【技术报告】第二届语音对话与听觉处理前沿进展研讨会技术报告(RASDAP2025) Technical Report
为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会发起的第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025,Recent Advances on Speech Dialogue…
30 0 0
AI人工智能视频声音生成初创公司 Mirelo 获得 4100 万美元的种子轮融资
来源丨AI音频时代 2025年12月16日,德国 音频初创公司 Mirelo AI宣布完成4100万美元种子轮融资。本轮融资由Index Ventures和Andreessen Horowitz领投,Atlantic.vc与TriplePo…
18 0 0
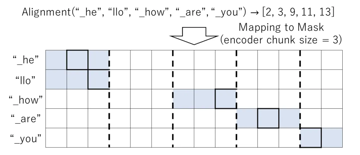
NTT新成果:All-in-One ASR统一三模型双模式,手机等轻量设备落地更轻松
标题:All-in-One ASR: Unifying Encoder-Decoder Models of CTC, Attention, and Transducer in Dual-Mode ASR 地址:https://arxiv.o…
30 0 1
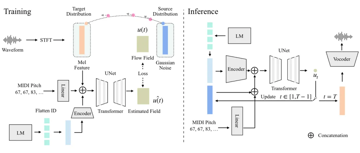
卡内基梅隆大学等团队改造SLM,实现高质量歌声合成
标题:Adapting Speech Language Model to Singing Voice Synthesis 链接:https://arxiv.org/pdf/2512.14657 作者单位:卡内基梅隆大学、中国人民大学、约翰霍…
21 0 0