论文导读丨CCF语音对话与听觉专委会论文导读(2026年第5期)

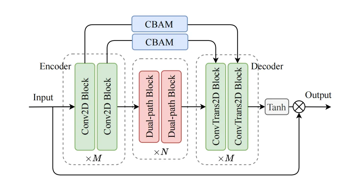
本期分享杭州电子科技大学和上海交通大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的语音增强方面的工作,论文链接、代码链接见文末。 SelfSE:Self-S…
27 0 0

本期分享杭州电子科技大学和上海交通大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的语音增强方面的工作,论文链接、代码链接见文末。 SelfSE:Self-S…
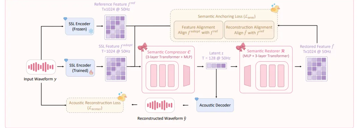
以下文章来源丨模型之声 标题:《WavCube: Unifying Speech Representation for Understanding and Generation via Semantic-Acoustic Joint Mod…
今天,阶跃正式发布新一代实时语音大模型StepAudio 2.5 Realtime! 我们希望创造更有“活人感”的 AI 聊天搭子:有温度、有灵魂、有态度。为此重点聚焦三大能力突破: 顶级副语言能力:实现真人级深度感知,精准听懂对话里的弦外…
来源|机器之心 AI 正在悄悄改变人与电脑的交互方式,而下一个被重塑的,可能就是每天发生几百次的「输入」这个动作。 语音输入并非新概念。从早期的 Siri、Google Assistant,到近几年 Whisper、Otter.ai 等工具…
论文标题:X-Voice: Enabling Everyone to Speak 30 Languages via Zero-Shot Cross-Lingual Voice Cloning 论文链接:https://arxiv.org/a…
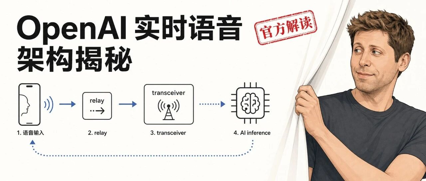
以下文章来源于丨赛博禅心 Realtime API 是 OpenAI 的实时语音交互接口,在 24 年的 DevDay 首次亮相,当时还是 beta,调用贵到离谱,音频输出 200 刀/百万 token:OpenAI 凌晨发布:Realti…
今天,Doubao-Seed-2.0-lite 升级新版本,这是豆包大模型家族首款全模态理解模型,支持视频、图像、音频、文本原生统一理解,Agent、Coding 与 GUI 能力同步升级。在同等算力成本下,是企业大规模、批量化部署全模态推…
在当前指令遵循式语音合成(Instruction-Following TTS)快速发展的背景下,如何系统性地评估模型是否真正“听懂并执行”了用户的自然语言声音指令,已成为制约该领域发展的关键瓶颈。现有的评测方案普遍面临覆盖维度有限、诊断粒度…
