声浪


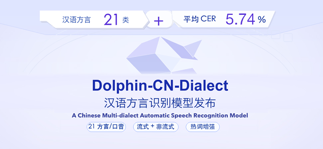
Dolphin-CN-Dialect 发布:同样的数据,换一种配方,让ASR听懂更多中国话
今天,海天瑞声与清华大学电子工程系语音与音频技术实验室(SATLab),发布Dolphin-CN-Dialect 汉语多方言语音识别模型! 获取渠道 体验地址 · 非流式识别:
55 0 0
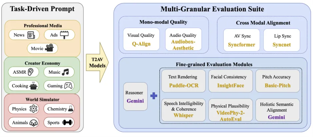
AVGen-Bench:面向下一代文生音视频模型的系统化评测框架
以下文章来源 微软亚洲研究院 微软亚洲研究院推出了一个面向文本生成音视频任务的多粒度、细粒度、任务驱动评测基准AVGen-近日,微软亚洲研究院推出了一个面向文本生成音视频任务的多粒度、细粒度、任务驱动评测基准AVGen-Bench。它关注的…
24 0 0
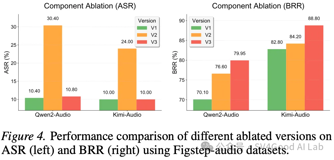
ICML 2026 | SARSteer:让大型音频语言模型学会"说不"
以下文章来源SV4Good Al Lab 大型音频语言模型(Large Audio–Language Models, LALMs)正在成为下一代语音交互、音频理解、实时对话系统的核心底座。然而最近的研究指出,音频输入比文本更容易诱发模型生成…
22 0 0
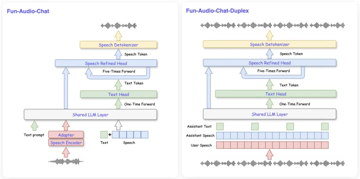
第三届CCF语音对话与听觉处理前沿进展研讨会技术报告(RASDAP2026 Technical Report)
当前语音对话与听觉处理领域蓬勃发展,学术界与工业界不断涌现创新的技术与产品,为了更好地推动经验交流与前瞻研讨,由中国计算机学会(CCF)语音对话与听觉专委会发起的第三届CCF语音对话与听觉处理前沿进展研讨会(RASDAP2026,Recen…
24 1 0
Ctx2Skill:如何让大模型从复杂文档直接构建 Skills?
近年来,大语言模型在复杂推理、代码生成以及智能体等方向不断突破,一个更接近真实世界的问题也逐渐浮出水面:模型是否真的能够从复杂上下文中学习? 现实中的许多任务,其关键知识并不存在于模型预训练记忆里,而是隐藏在冗长、专业且此前从未见过的专业文…
35 0 0