NTU、NUS、上海AI Lab联合开源 Mega-ASR:刷新真实世界高噪语音识别纪录,复杂环境相对 SOTA 降 WER 超 30%,消费级显卡可跑

以下文章来源于一杯阔乐聊ai 面向“全场景复杂环境”:Mega-ASR 引入双粒度强化学习,领跑现有开源语音识别方案 资源导航 论文链接:https://arxiv.org/abs/2605.19833 项目主页:https://xzf-t…
36 0 0

以下文章来源于一杯阔乐聊ai 面向“全场景复杂环境”:Mega-ASR 引入双粒度强化学习,领跑现有开源语音识别方案 资源导航 论文链接:https://arxiv.org/abs/2605.19833 项目主页:https://xzf-t…
以下文章来源于SV4Good AI Lab 近来,大型音频语言模型(Large Audio Language Model,LALM)的蓬勃发展使得声音这一人类最为自然的交流媒介被越来越多地用于与大模型的交互之中。然而,新的音频模态的引入也自…
跨境直播卡顿、跨国会议延迟、AI配音“机器感”太重……实时同传一直卡在“延迟、语种、音色”三大痛点。 Qwen3.5-LiveTranslate-Flash给出了解决方案:支持60种语言的音频输入和文字输出,29种语言的音频输出,端到端字均…
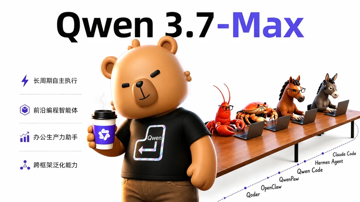
来源丨通义实验室 刚刚,通义发布了 Qwen3.7-Max ——面向智能体时代的新一代旗舰模型,即将通过 API 提供服务。Qwen3.7-Max 致力于成为全能的智能体基座——无论是编写和调试代码、自动化办公流程,还是在跨越数百乃至数千步…
李航,张少华,林苑 我们每天都在使用大语言模型(Large Language Model,LLM)。一个明显的感受是,它们似乎真的能够理解我们的语言,虽然有时也会出现幻觉。另一方面,观察 LLM 输出的思维链,也就是其推理过程的语言表示,我…
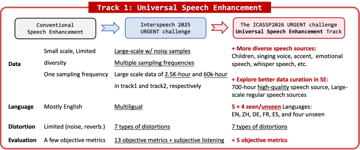
本期为大家介绍基于ICASSP 2026 URGENT 语音增强比赛的总结论文[1]。在本届 ICASSP 2026 中,我们围绕 URGENT Challenge 的组织与评测工作,完成了 challenge overview 论文。 I…
全球研究者注意:论文预印本上传平台 arXiv 又出新规了! 今天凌晨,俄勒冈州立大学杰出教授(荣休)、arXiv 计算机科学分区 CoRR 的机器学习板块首席版主 Thomas G. Dietterich 宣布:根据我们的行为准则,在论文…
