
Qwen 团队开源 23 种语言 Agent 评测基准

Qwen 团队与高校及蚂蚁国际研究者推出 BabelArena,并在魔搭社区开源多语言 Agent 评测数据:23 种语言、13 个领域、702 个原始任务,共 16,146 个语言版本。 配套工作流 BabelFlow 协同适配任务、提示…
331 0 0
Qwen 团队与高校及蚂蚁国际研究者推出 BabelArena,并在魔搭社区开源多语言 Agent 评测数据:23 种语言、13 个领域、702 个原始任务,共 16,146 个语言版本。 配套工作流 BabelFlow 协同适配任务、提示…

NVIDIA 发布了开放权重语音模型 Nemotron 3.5 Transcribe,同时推出 Granary v2 多语言数据清单和可复用的数据整理流水线。单个模型即可完成语音转写、说话人归属标注、翻译和音频问答。 该模型支持 40 种语…

论文题目|VoxDub: A Bilingual Lip-Synchronized Audio-Visual Dataset for Automatic Video Dubbing 作者|王恺迪、管文豪、陈培杰、吴炜杰、林学涛、李琳、洪青阳…

近年来,大语言模型(Large Language Model, LLM)在语音、图像等多模态领域快速发展,空间智能也成为人工智能的重要方向。空间智能,是机器感知、理解和推理三维物理世界的能力,也是实现全场景智能生态的重要基础。 今天,小米开…
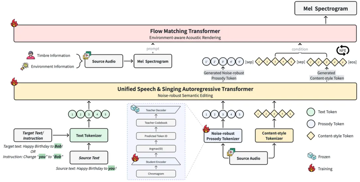
论文题目:AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency 收录会议:Ne…
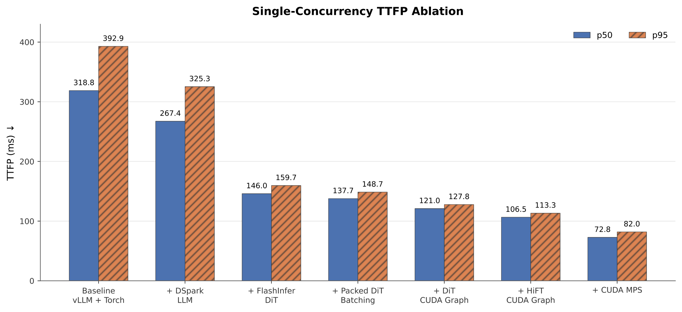
Faster CosyVoice是 CosyVoice3 语音合成模型的开源 GPU 推理方案。通过 speculative decoding、FlashInfer DiT、跨请求 packed batching、deadline-awar…

实时语音交互最怕的,不只是“没听懂”。 更危险的是:话音刚落,系统已经执行了错误指令;几百毫秒后识别结果又改了,但动作无法撤回。 当 Voice Agent 开始控制设备、调用 API、触发工作流,ASR 输出就不能再“边猜边改”。它既要足…

Cactus Compute 发布开源语音识别模型 Whistle,面向手机、可穿戴设备、机器人、汽车和微控制器等端侧设备。 模型文件仅 16.9MB,直接在 CPU 上运行,并与其端侧工具调用模型 Needle 共用同一套 C++ 推理引…
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。 相比此前主要面向语音识别的 YODAS,v3 加…

过去两年,TTS(文本转语音)赛道的竞争焦点发生了一次微妙的转移。 早期大家比的是“像不像真人”——音色克隆、自然度、音质MOS分。但当ElevenLabs把Voice Design的概念带火之后,一个新的问题浮出水面:一个声音“好听”,不…