
声浪

INTERSPEECH 2025丨智能语音信息处理团队15篇录用论文分享

分享语音及语言信息处理国家工程研究中心智能语音信息处理团队中稿的15篇论文,论文方向涵盖语音识别、语音合成、语音编码、话者识别、语音增强、情感识别、声音事件检测等,各接收论文简介见后文。 01、Improving Noise Robustn…
30 0 0
【活动预告】INTERSPEECH 2025 论文预讲会启动
INTERSPEECH 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2025 录用论文的作者进行报告交流。 INTERSPE…
13 0 0
INTERSPEECH 2025丨THUHCSI 实验室8篇录用论文分享
分享清华大学人机语音交互实验室(THUHCSI)中稿的8篇论文,内容涉及智能语音交互领域的诸多研究方向,包括语音大模型泛化能力、自回归语音合成加速、文本驱动的可控语音转换、歌声转换、构音障碍语音重建、音频水印及其对抗防御等。论文工作将学术科…
26 0 0
重磅开源!首个全异步强化学习训练系统,SOTA推理大模型RL训练提速2.77倍
来源丨机器之心 清华大学交叉信息院和蚂蚁技术研究院的联合团队开源全异步强化学习训练系统 —— AReaL-boba² (AReaL v0.3)。 作为 AReaL 里程碑版本 AReaL-boba 的重磅升级,AReaL-boba² (正式…
14 0 0
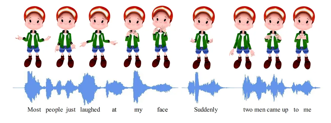
CVPR 2023 | 基于量化和相位引导的语音驱动自然手势生成
本文由清华大学与华为、香港中文大学合作,研究共语手势(co-speech gesture)的自动生成。语音驱动的手势生成因人类动作的随机抖动和语音与手势之间固有的异步关系而面临重大挑战。为应对这些问题,我们提出了一种新颖的基于量化和相位引导…
13 0 0
吴恩达评AI Agents现状!
来源丨InfoQ 前几天,吴恩达与 LangChain 联合创始人 Harrison Chase 展开了一场对话,而这场对话的背景,正是当前 AI 领域既充满机遇又挑战重重的一个现实。 视频链接:https://www.youtube.co…
18 0 0
单卡也能跑万帧!智源发布Video-XL-2,速度、效果、长度全拉满
来源丨新智元 智源研究院发布开源模型Video-XL-2,显著提升长视频理解能力。该模型在效果、处理长度与速度上全面优化,支持单卡处理万帧视频,编码2048帧仅需12秒。 长视频理解是多模态大模型关键能力之一。尽管OpenAI GPT-4o…
14 0 0