
声浪

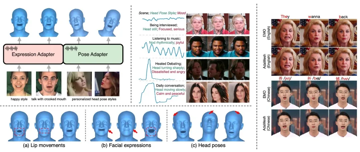
AdaMesh:让虚拟角色“活”起来:语音驱动的人脸动画如何迈向个性化?

语音驱动的三维人脸动画旨在根据输入语音生成同步的面部运动,这项技术近年来受到了广泛关注。然而,现有方法普遍忽略了说话者的个性化风格,例如独特的面部表情和头部姿态,导致生成的人脸动画缺乏真实感和个性表达。部分工作尝试通过微调模型来建模不同人物…
11 0 0
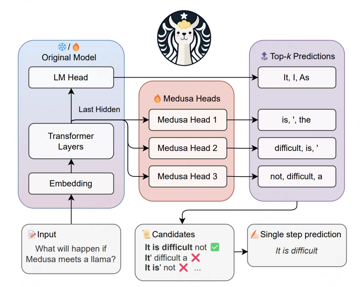
【交我学-3】一文看懂LLM推理无损加速方法:投机解码
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
9 0 0
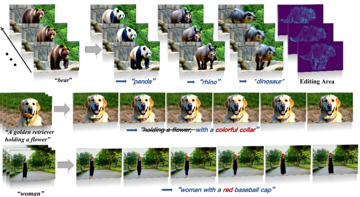
SOTA级视频编辑新方法:无需训练一句话编辑视频,背景保持100%
FlowDirector团队投稿 量子位 | 来源 AI的视频编辑方法总是存在一些问题:例如视频运动不连贯、编辑后的视频产生意外变化等……经过分析,这些问题的产生最终大都指向同一原因——反演-编辑范式。 因此,西湖大学AGILab提出了一种…
14 0 0
AISHELL-5 全球首套智能驾舱中文语音交互数据集开源
随着汽车成为人们日常生活中不可或缺的一部分,而驾驶舱中传统的触摸交互方式容易分散驾驶员的注意力,存在安全风险,因此,车内基于语音的交互方式得到重视。与通常家庭或会议场景中的语音识别系统不同,驾驶场景中的系统面临更加独特的挑战,缺乏大规模的公…
35 0 0
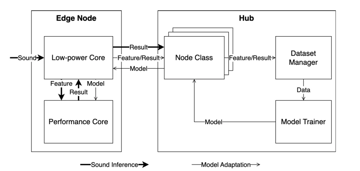
基于位置感知的环境声音模型自适应系统:助力边缘计算中的人体活动识别
在智能家居、老年护理和行为监测等领域,人类活动识别(Human Activity Recognition, HAR)技术的应用日益广泛。传统的HAR系统通常依赖于可穿戴设备、传感器网络或音视频数据来检测和分类人类活动。然而,基于声音的HAR…
7 0 0
ACMMM 2024|Speechcraft:大规模自然语言细粒度描述的表现力语音数据集
本文介绍清华大学人机语音交互实验室(THUHCSI)在会上发表的第1篇论文:Speechcraft:大规模自然语言细粒度描述的表现力语音数据集。 文本-语音多模态学习任务(Speech-language Multimodal Learnin…
13 0 0
梅宏院士:人工智能模型与开源的几点认识
2025年伊始,大语言模型DeepSeek在继2022年底ChatGPT带来人工智能(artificial intelligence,AI)的“现象级”应用之后,再度带来了新一波全球性的大模型应用和讨论的热潮,甚至被视为某些世界性事件的诱因…
25 0 0