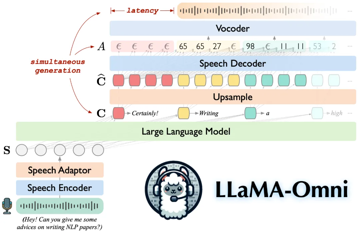
国内团队最新开源模型,仅用4块GPU、不到3天训练出「开源版GPT-4o」

来源丨机器之心 LLaMA-Omni能够接收语音指令,同步生成文本和语音响应,响应延迟低至 226ms,低于 GPT-4o 的平均音频响应延迟 320ms。 论文标题:LLaMA-Omni: Seamless Speech Interact…
10 0 0

来源丨机器之心 LLaMA-Omni能够接收语音指令,同步生成文本和语音响应,响应延迟低至 226ms,低于 GPT-4o 的平均音频响应延迟 320ms。 论文标题:LLaMA-Omni: Seamless Speech Interact…
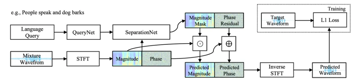
近年来,多模态模型(Multimodal Models)在深度学习领域取得了显著进展。这类模型能够同时处理和整合来自不同模态(如文本、图像、音频、视频等)的数据,提供更为全面的理解和应用能力。CLIP、Grounding DINO、SAM等…
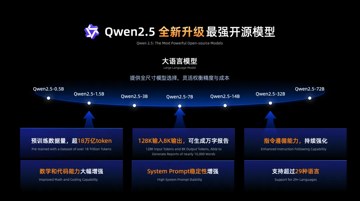
今天凌晨,阿里官宣了史上最大规模的开源发布,推出了基础模型Qwen2.5、专用于编码Qwen2.5-Coder和数学的Qwen2.5-Math。 开源地址:https://huggingface.co/collections/Qwen/qw…
字节正式发布Seed-Music音乐生成大模型,整个AI音乐框架非常全面且创新,涵盖了从音频编辑、旋律生成到完整歌曲制作的全流程。 项目主页:https://team.doubao.com/seed-music 论文链接:https://l…
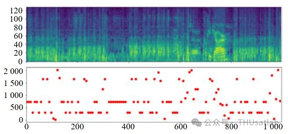
阿尔茨海默病(Alzheimer’s Disease,AD)是全球范围内最常见的神经退行性疾病之一。随着人口老龄化加剧,AD患者的数量也逐年增加,给社会医疗体系带来了巨大的压力。早期诊断对于减缓疾病进展至关重要,然而传统的诊断方法往往依赖于…
近日,张俊林在新浪微博发布了对关于OpenAI o1 的价值意义及 RL 的 Scaling law。 一、OpenAI o1 是大模型的巨大进步 我觉得 OpenAI o1 是自 GPT 4 发布以来,基座大模型最大的进展,逻辑推理能力提…
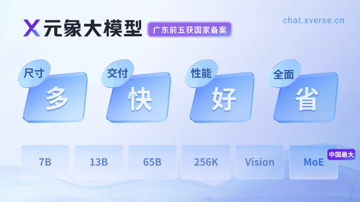
来源丨机器之心 元象 XVERSE 发布中国最大 MoE 开源模型:XVERSE-MoE-A36B,加速 AI 应用低成本部署,将国产开源提升至国际领先水平。 该模型总参数 255B,激活参数 36B,达到 100B 模型性能的「跨级」跃升…
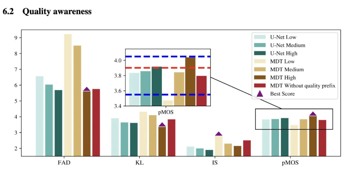
中科大与科大讯飞研究团队开源高质量音乐文本控制音乐生成模型,轻松实现震撼生成效果! 论文地址:https://arxiv.org/pdf/2405.15863 开源地址:https://github.com/ivcylc/qa-mdt De…
大模型领域的技术发展,今天起再次「从 1 开始」了。 就在刚刚,OpenAI最强的o1系列模型忽然上线。毫无预警地,OpenAI就扔出这一声炸雷。传说中两周内就要上线的草莓模型,居然两天内就来了! 从今天开始,o1-preview在Chat…
Mini-Omni是一个开源多模态大型语言模型,具备实时对话能力和端到端的语音输入输出功能。通过独特的文本指导并行生成方法,实现了与文本能力一致的语音推理输出,仅需极少的额外数据和模块。 论文题目:Mini-Omni: Language M…