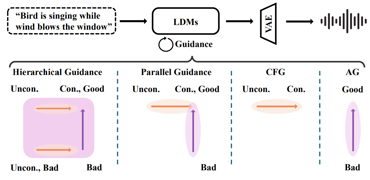
ICME 2026 | AudioMoG: 基于嵌套引导机制的高效音频生成方法

文生音频(Text-to-audiogeneration, T2A)与视频配音(Video-to-audiogeneration, V2A)等音频生成任务近年来随着扩散模型的发展取得了显著进展。现有研究从数据空间、网络结构以及条件控制等多个…
19 0 0

文生音频(Text-to-audiogeneration, T2A)与视频配音(Video-to-audiogeneration, V2A)等音频生成任务近年来随着扩散模型的发展取得了显著进展。现有研究从数据空间、网络结构以及条件控制等多个…
以下文章来源于Amphion,作者Amphion Team 「现存问题」 这几年,端到端 Speech LLM 进步很快: 语音输入可以直接问答 不再必须“ASR转文字 → 再丢给LLM” 看起来离“直接听懂并推理”已经很近了 但一个很顽固…
你有没有想过,一首歌能不能任意改词,旋律保持不变? 想象一下这样的场景:你特别喜欢一首歌的旋律,但歌词想换成自己写的;或者你想把一首中文歌"翻唱"成英文版,旋律保持不变,歌词却是全新的英文内容。以前要做到这件事,要么得先提取MIDI,手动对…
来源丨RTE开发者社区 近日,MOSI.AI 和 OpenMOSS 团队 开源了MOSS-TTS-Nano,一个0.1B参数 的多语言微型语音生成模型,直接把“实时语音克隆”门槛打到了地板价。 MOSS-TTS-Nano 专注于 TTS 部…
未来生活实验室是阿里集团旗下的核心AI研发与产品化部门。我们深耕多模态大模型领域,致力于打破交互边界,重新定义数字生活的未来。通过聚焦多模态技术研究,我们持续挑战智能上限,实现视觉、听觉与语言的高维度融合;同时,我们积极探索并定义新一代多模…
论文链接: https://arxiv.org/pdf/2508.06098v2 代码链接: https://github.com/xiquan-li/MeanAudio 发表会议: ACL 2026 近年来,文本转音频生成(TTA)技术取…
来源丨开源星探 做视频剪辑的人都懂,从几小时的素材里剪出一段踩点精准、叙事流畅的短视频有多折磨人。 特别是对于旅拍博主和Vlogger来说,拍了一天5-6小时的素材,回来还要花好几个小时慢慢剪,真正的创作热情都被这种机械劳动消磨掉了。 更别…
