微信 Audio-Omni:一个模型通吃声音 / 音乐 / 语音,理解生成编辑全搞定,7.9B 参数碾压专用模型

论文链接: https://arxiv.org/abs/2604.10708v1 代码链接: https://zeyuet.github.io/Audio-Omni 发表会议: arxiv Sora 带火了视频生成,但音频 AI 却一直深陷…
33 0 0

论文链接: https://arxiv.org/abs/2604.10708v1 代码链接: https://zeyuet.github.io/Audio-Omni 发表会议: arxiv Sora 带火了视频生成,但音频 AI 却一直深陷…
论文标题:Seedance 2.0: Advancing Video Generation for World Complexity 论文链接:https://arxiv.org/abs/2604.14148v1 代码链接:https://…
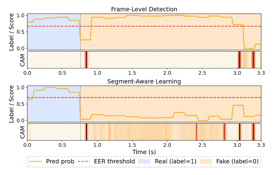
随着语音合成与语音转换技术的快速发展,语音深度伪造(Speech Deepfake)正变得愈发逼真与普及。从早期的整句生成,到如今更具隐蔽性的局部篡改(Partial Spoofing),攻击者可以仅修改语音中的关键片段(如数字、人名或关键…
体量轻巧、推理高效,Qwen3.6-35B-A3B 开源! 这是一款采用稀疏混合专家(MoE)架构的高效模型:总参数350 亿,每次推理仅激活30 亿参数。 参数量虽小,性能依旧强劲。在智能体编程上,它大幅超越前代 Qwen3.5-35B-…
来源丨智东西,作者:王涵,编辑:李水青 阿里首个世界模型突然发布!实测一点不比李飞飞的逊色? 智东西4月16日报道,刚刚,阿里ATH创新事业部发布了其首款开放式世界模型HappyOyster(快乐生蚝)。 基于原生多模态架构,该模型支持多模…
今天,阶跃发布新一代语音生成模型StepAudio 2.5 TTS! 围绕全局语境控制、文中语境控制、零样本复刻与全音色控制三项核心能力, StepAudio 2.5 TTS 让语音生成更自然、更灵活也更有表现力。 全局语境控制:支持自定义…
来源丨智东西,作者:江宇,编辑:漠影 腾讯正式发布并开源混元3D世界模型2.0(HY-World 2.0)。作为一款多模态的世界模型,HY-World 2.0支持文字、图片和视频等形式输入,可自动生成、重建并模拟完整的3D世界。 对于游戏行…
标题:《Audio Flamingo Next: Next-Generation Open Audio-Language Models for Speech, Sound, and Music》 链接:https://arxiv.org/a…
