混元Embodied-0.5开源:专为现实世界具身智能体设计,通向物理Agent开源新基座

让大模型真正走进现实世界,是当下最迫切的需求之一。但美好的愿景,在真实的物理环境面前却屡屡碰壁。那些在文本世界里对答如流的通用视觉语言模型(VLM),一旦装进机器人脑子里,常常显得笨手笨脚。 原因很简单——物理世界容不得半点含糊。通用模型平…
20 0 0

让大模型真正走进现实世界,是当下最迫切的需求之一。但美好的愿景,在真实的物理环境面前却屡屡碰壁。那些在文本世界里对答如流的通用视觉语言模型(VLM),一旦装进机器人脑子里,常常显得笨手笨脚。 原因很简单——物理世界容不得半点含糊。通用模型平…
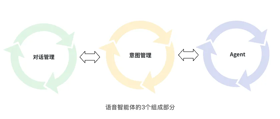
豆包的语音对话升级到了双全工模式。普通用户也许不知道“双全工”是什么,也不在意这个拗口名词的技术定义,但能直接感受到的变化可能是: 对话更流利 想打断时可以随时打断,系统还能自行判断是否应该被打断 豆包知道什么时候不该回应(比如噪声,或与对…
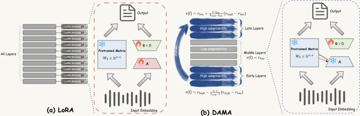
针对低资源语言适配中“高成本—低稳定性”的核心矛盾,本文揭示了多语言语音模型沿深度方向的 U 型可塑性规律,并提出深度感知适配框架 DAMA。在保持竞争性识别性能的同时,DAMA 将可训练参数减少约 80%,并在极低资源设置下实现约 29%…
One-shot Voice Conversion(单样本语音转换)这件事,直观理解就是: 给模型一段“你说的话”,再给它一小段“目标说话人”的参考音,模型输出的语音内容不变,但音色变成目标说话人。 这类技术在论文demo里通常效果很好。但…
今天,字节正式推出原生全双工语音大模型 Seeduplex。相比于上一代半双工豆包端到端语音模型,Seeduplex 基于“边听边说”的全新框架设计,交互体验的自然感、顺畅度大幅提升。 如果说端到端架构通过统一“听”“说”模块,让 AI 拥…
歌曲结构标注(MSA)是一种能够识别歌曲中具有功能意义的段落(如前奏、主歌、副歌)并精准检测其边界的技术,正日益成为音乐理解和可控音乐生成的重要支撑技术。然而,现有的 MSA 方法通常由于训练数据规模有限、标注不一致、依赖复杂预处理流程等原…
生成式通用语音增强(Universal Speech Enhancement, USE)旨在利用生成式模型改善各类失真条件下的语音质量。当前主流方法虽能有效提升感知质量,但在语义一致性方面仍面临挑战——生成语音常出现语义偏差、词汇误换或上下…
来源丨新智元、AI小展厅 面壁智能2B小模型VoxCPM 2惊艳开源,一众外国网友疯狂了!30种语言与9大方言它是信手拈来,复刻的贺炜激昂解说与徐志胜脱口秀,相似度简直直击灵魂。这哪是工具,分明是降维打击的生产力核武器! VoxCPM 2,…
