
声浪

鱼亮科技丨招聘多模态语音增强(AVSE)算法工程师

鱼亮科技成立于2017年,专注于打造全球领先的边缘智能语音交互解决方案,其融合了弱场景的前端AI耳朵感官,离端本地化的语音语言AI模型为终端用户提供弱网、无网络、高噪声场景极致的AI交互体验。 公司云集了业内顶尖的技术专家和经验丰富的产业化…
200 0 0
ICASSP 2026|MeanVC:基于平均流的轻量级流式零样本语音转换
零样本语音转换(Zero-shot VC)旨在保留语音语言内容的同时,将源说话人音色迁移至任意未见过的目标说话人。日益丰富的应用场景对模型的流式推理能力提出迫切需求,亟需兼具快速、轻量与高保真特性的解决方案。然而现有流式方法依赖自回归(AR…
18 0 0
Suno 5.5 发布 允许用户克隆声音演唱 AI 生成歌曲
AI音乐公司Suno正式发布其音乐生成器5.5版本。除了音质提升外,用户现在还可以用自己的声音演唱歌曲,并训练模型以匹配个人风格。Suno推出了其音乐模型的5.5版本,该公司称这是其“迄今为止最好、最具表现力的模型”。此次更新围绕三项新功能…
21 0 0
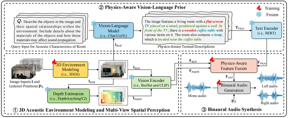
ICASSP 2026|Phys-NVAS:基于视觉语言模型物理先验挖掘与3D声学环境建模的新视角声学合成
作者:罗立昂,编辑:冯小雨,审核:关键 在追求沉浸式体验的道路上,空间音频扮演着至关重要的角色。想象一下,在虚拟现实中,不仅能看到逼真的场景,还能听到与场景几何、物体材质、布局息息相关的真实声场,这才是真正的“身临其境”。然而,新视角声学合…
17 0 0
ICASSP2026|首届类人语音对话系统(HumDial)挑战赛总结
随着大语言模型(LLMs)特别是音频大模型(Audio-LLMs)和全能模型(Omni-models)的快速发展,口语对话系统取得了显著进步,不断缩小人机交互与人人交互之间的差距。为了实现真正“类人”的交流,系统需要具备双重能力:一是感知并…
25 0 0
通用语音识别模型VibeVoice ASR:长达60分钟音频一次性“直出”结构化转写
本文来源丨微软亚洲研究院 近日,微软亚洲研究院发布了一款通用的语音识别模型VibeVoice ASR,单次转录可处理长达 60 分钟的连续音频,并能够可靠地生成丰富、结构化的输出,清晰地记录说话者是谁以及其说话时间。作为一种全新的语音识别范…
25 0 0
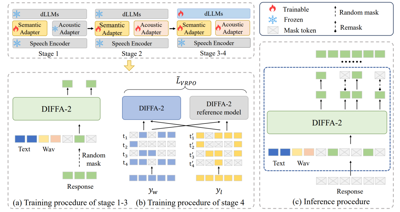
DIFFA-2:面向通用音频理解的扩散语言音频大模型
本文介绍的是南开大学人机语言技术实验室(NKU-HLT)与美团 LongCat Interaction 合作团队近期完成的一项研究工作——DIFFA-2。该工作延续了在 AAAI 2026 提出的 DIFFA(DIFFA: Large La…
26 0 0