Agent 语音交互如何更稳、更快?一次高并发消息链路优化实践

本文来源:阿里云云原生 作者:雀贤、文婷、复礼、稚柳 随着大语言模型(LLM)、语音识别(ASR)、语音合成(TTS)等能力逐步成熟,AI Agent 开始从文本交互走向语音交互,典型场景包括 AI 教师、AI 情感聊天、AI 助手等。相比…
20 0 0

本文来源:阿里云云原生 作者:雀贤、文婷、复礼、稚柳 随着大语言模型(LLM)、语音识别(ASR)、语音合成(TTS)等能力逐步成熟,AI Agent 开始从文本交互走向语音交互,典型场景包括 AI 教师、AI 情感聊天、AI 助手等。相比…
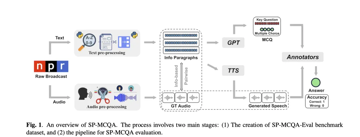
「现存问题」 TTS(文本转语音)这两年进步很快,很多模型在测试集上能做到很低的 WER(词错误率),听起来“字面上没问题”。 但现实场景里,用户真正关心的往往不是“每个词都对”,而是: 这段语音里提到的关键信息我能不能抓住?例如:日期、金…
来源丨新智元 AI音乐变天了!Mureka V8强势登顶AA榜,包揽人声与器乐双项冠军。而这仅仅是开始,下一代Mureka V9已在路上了! 双榜封顶,实至名归! 就在今天,AI音乐大模型Mureka V8在权威Artificial Ana…
现在的配音模型有时会“顾此失彼”:为了追求声音像,可能时机就不准了;为了追求时机准,音质有可能会变差。这是因为模型试图用一套标准同时满足所有要求,导致目标之间互相“打架”。 为了解决这个问题,通义实验室开源发布了PrismAudio。 论文…
开源多模态生成领域,迎来架构级的底层突破。 视频生成已成为当前生成式 AI 最前沿的方向,但在音视频联合同步生成领域,开源界仍面临三重局限: 音视频不同步:视频和音频往往语义对齐精度不足。 架构设计复杂:现有方案要么将音频视为从属信号,要么…
在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生…
AudioCC交我学 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。…
