Fun-CineForge丨通义开源首个支持影视级多场景配音的多模态大模型

通义发布并开源了首个支持影视级多场景配音的多模态大模型Fun-CineForge。此外,还配套开放了高质量数据集的构建方法。通过“数据 + 模型”的一体化设计,Fun-CineForge 正尝试解决影视级 AI 配音长期面临的关键问题。 在…
19 0 0

通义发布并开源了首个支持影视级多场景配音的多模态大模型Fun-CineForge。此外,还配套开放了高质量数据集的构建方法。通过“数据 + 模型”的一体化设计,Fun-CineForge 正尝试解决影视级 AI 配音长期面临的关键问题。 在…
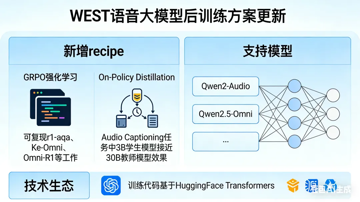
WEST 新增了 GRPO 强化学习和 On-Policy Distillation 两个 recipe,支持对 Qwen2-Audio、Qwen2.5-Omni 等音频模型做后训练。GRPO 方案可复现 r1-aqa、Ke-Omni、Om…
基于神经网络的方法使语音分离技术取得显著进步,在信号层面的指标上表现更佳。然而,这些方法往往难以在分离信号中保持语音可懂度,这会对语音识别等下游任务的性能产生负面影响。本文提出SLM-SS方法,通过将语音语言模型应用于语音分离,旨在提升分离…
论文标题:Covo-Audio Technical Report 论文链接:https://arxiv.org/pdf/2602.09823v1 当语音助手能听懂指令、生成语音时,却常陷入 “逻辑脱节、交互僵硬、音色难定制” 的困境,要么只…
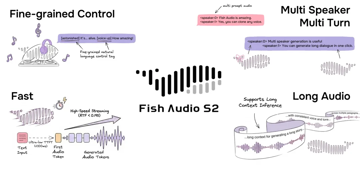
来源丨RET开发者社区 传统的AI语音合成往往因缺乏情感表达而显得机械生硬。Fish Audio最新开源的文本转语音模型Fish Audio S2,致力于解决这一痛点。该模型能够生成包含清嗓、叹息、笑场等细微人类声学特征的语音。 模型权重、…
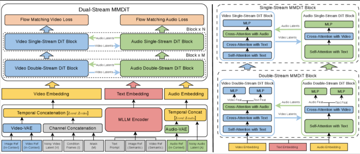
来源丨AI音频时代 AI似乎已经无处不在,而我们身处的内容产业,AI内容生成技术也像极了即将到来的暴风骤雨,但无论是否还要继续坚持,我们都应该去了解这里面发生了什么。而多年来,视频生成和音频生成一直像两个陌生人,分别待在不同的制造车间里。当…