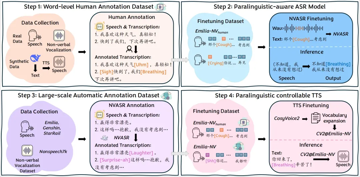
Emilia-NV:让ASR/TTS有“人味儿”的秘诀 | ICASSP2026

我们平时说话,信息不只在“字面内容”里,还藏在各种副语言声音里:笑、喘气、叹气、咳嗽,以及“嗯/啊/哦”这类带态度的语气词。它们在真实对话里承担了大量功能: 表达情绪与态度:开心的笑、无奈的叹气、不耐烦的“哼” 组织对话节奏:思考时的“呃/…
35 0 0

我们平时说话,信息不只在“字面内容”里,还藏在各种副语言声音里:笑、喘气、叹气、咳嗽,以及“嗯/啊/哦”这类带态度的语气词。它们在真实对话里承担了大量功能: 表达情绪与态度:开心的笑、无奈的叹气、不耐烦的“哼” 组织对话节奏:思考时的“呃/…
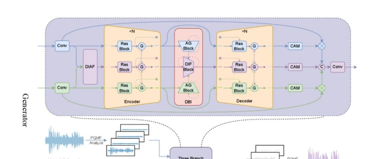
来源丨21db声学人 在极低信噪比环境下,传统语音增强系统性能急剧下降,气导麦克风常被环境噪音淹没。近日,来自军事科学院国防科技创新研究院、中国科学院声学研究所和计算技术研究所的研究团队提出了一种名为深度平衡多模态迭代融合框架(DBMIF)…
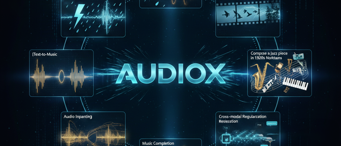
来源丨新智元 港科大团队提出音频生成统一模型AudioX,只需一个模型,就能从文本、视频、图像等任意模态生成高质量音效和音乐,在多项基准上超越专家模型。团队同时开源了700万样本的细粒度标注数据集IF-caps与可控T2A评测基准T2A-b…
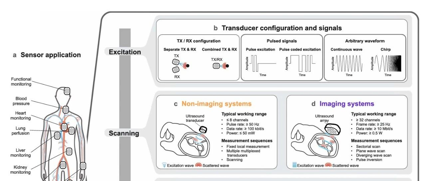
来源丨21db声学人 近年来,可穿戴超声技术正在从实验室原型走向真实应用场景。这项技术能够实现连续、无创、深层次的组织监测,在医疗健康、人机交互、康复训练等领域展现出巨大潜力。 近日发表于IEEE Reviews in Biomedical…
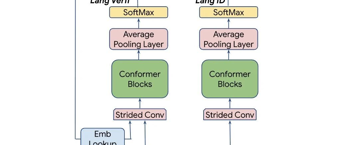
AudioCC交我学 在全球化浪潮下,多语种语音识别(Multilingual ASR)技术成为打破语言壁垒的关键支撑。从低资源语种适配到零资源场景突破,从模型效率优化到实际场景落地,近期 Interspeech、ICASSP 等顶会涌现出…
通义实验室这次带来的是Mobile-Agent-v3.5以及最新的原生 GUI Agent 模型家族GUI-Owl-1.5:面向桌面 / 移动 / 浏览器等多端统一的基础模型与训练范式,并已全面开源。 模型链接: GUI-Owl-1.5-2…
以下文章来源于AI语音AI思考 本系列共十篇文章,旨在深入剖析之前提到的十大趋势。 关于未来语音技术和应用趋势的10点看法 文章将穿插科普知识、技术综述、发展路线,以及我个人和其他行业专家的思考。无论读者此前对语音技术与应用了解多少,都希望…
