Qwen深度研究一夜升级!可生成网页和音频播客,新模型能认医生手写体

来源丨量子位 Qwen版深度研究加速进化,一觉起来增加了听觉和视觉输出: 可以生成网页和音频了。 AI深度研究整合的内容,变成图文并茂的网页,还可以一键部署,任何人可凭链接查看,方便对外展示。 长篇文字内容也可以变成音频播客,方便自己在碎片…
20 0 0

来源丨量子位 Qwen版深度研究加速进化,一觉起来增加了听觉和视觉输出: 可以生成网页和音频了。 AI深度研究整合的内容,变成图文并茂的网页,还可以一键部署,任何人可凭链接查看,方便对外展示。 长篇文字内容也可以变成音频播客,方便自己在碎片…
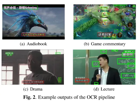
WenetSpeech 家族就像是一场前赴后继的饕餮盛宴。前赴后继是指 WeNet 社区的小伙伴们在数据的投入上前赴后继,不断探索新的边界,你方唱罢我登场;而饕餮盛宴,不是一道菜,而是源源不断的菜品,是社区给开发者、公司、研究人员不断的献礼…
全长度歌曲生成(Lyrics-to-Song Generation)任务的目标是根据输入的歌词和风格提示生成一首完整的歌曲,包括人声和伴奏。该任务涵盖了歌声合成、歌词建模和音乐生成,挑战性极大。近年来,随着深度生成模型的发展,歌词驱动的歌曲…
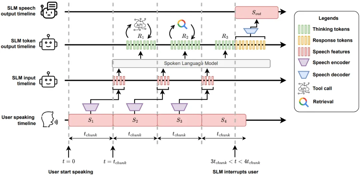
ChatGPT、DeepSeek等语言模型具备「深度推理」(Reasoning)能力,这类模型会在回答问题前先进行一段较长的推论过程,使回答的品质大幅提升。 不过,这种「等使用者说完话才开始思考」的方式,虽然在纯文字的使用场景能够被接受,却…
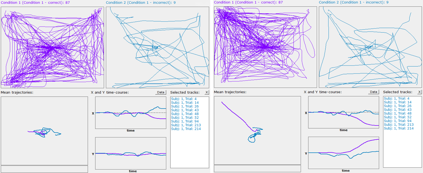
东南大学外国语学院博士生导师陈彧教授和博士生王一诺、北京航空航天大学外国语学院博士生曹盛勤,东南大学外国语学院博士后研究员李洋在语言学SSCI、A&HCI 期刊Lingua发表题为Mandarin Citation Tone Percept…
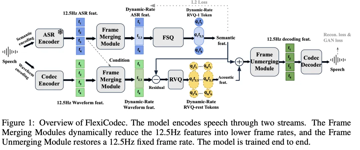
FlexiCodec是一个支持推理时动态调整平均帧率至3Hz到12.5Hz之间的Codec。 论文预印版:https://arxiv.org/abs/2510.00981 模型展示页面:https://flexicodec
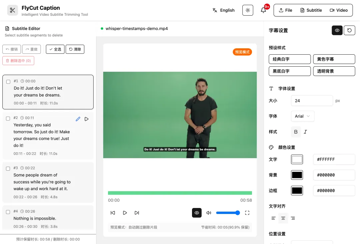
分享一款非常实用、创意十足的开源AI视频字幕编辑工具 — FlyCut Caption。 它不是那种复杂到需要剪辑经验的视频编辑器,而是一款基于 AI 的智能字幕编辑工具,能让你通过“改字幕”来“剪视频”。 也就是它不仅能智能生成字幕,还支…
