
声浪

MNV-17开源: 包含了17类非语言发声(NV)的ASR数据集,为NV感知ASR建立新基准

主流自动语音识别(ASR)系统在转写词汇内容上表现优异,但普遍忽略了语音中蕴含的叹气、笑声等非语言发声(Nonverbal Vocalizations, NVs)。这一能力缺失限制了系统对人类交流意图与情感的全面理解,使得NV感知ASR(N…
20 0 0
声音如何助力医疗创新
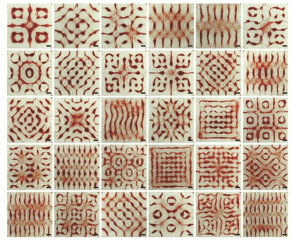
自从两百多年前第一支听诊器问世以来,从那时起到引力波那一瞬间短暂的“啾啾”声,声音在科技与科学发展的历史中始终回荡不息。 如今,声音在科学中的角色早已超越了人类可听的范围:超声波以及其他“无声”的声波,正被研究人员广泛应用,帮助他们突破传统…
21 0 0
可将任何音频文件分离的AI技术 AUDIOSHAKE A轮融资 1400 万美元
来源丨AI音频时代 10 月 2 日消息,AI音频公司 Audioshake 获得了 1400 万美元的新一轮融资,由风险投资公司 Shine Capital 领投,将用于扩大 Audioshake 的团队,进一步开发其产品。 AudioS…
12 0 0
腾讯开源模型 SongBloom 实现精度与质感的双重越级,告别AI音乐“塑料感”
来源丨腾讯开源 近日,腾讯 AI Lab与香港中文大学(深圳)、南京大学联合研发的歌曲生成模型SongBloom,相关研究成果被全球顶级人工智能会议NeurIPS 2025录用。 SongBloom 是一款聚焦歌曲生成的创新模型,只需输入…
22 0 0
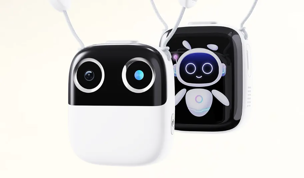
能识别儿童语音情绪!浙大研究员的“AI情绪翻译器”,重塑儿童陪伴产品
来源丨AI.X硬件产品 在儿童教育产品市场上,大多数硬件产品仍然聚焦于应试教育,而对于培养孩子综合素质的通识教育领域,市场上的产品较为有限。 基于这一需求,杭州千悟智能科技有限公司研发出穿戴式儿童AI陪伴产品——“千知精灵”。 它利用多模态…
19 0 0