【交我学-9】语音合成中的强化学习

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
10 0 0

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
最近,OpenAI 的 GPT Realtime 和 Google 的 Gemini 2.5 接连亮相,给语音助手带来了「真正的“实时对话”」体验 —— 你说一句,它就秒接;它正说,你也能随时打断,回应自然不尬聊。这才是真正像人一样“插话”…
SoundAI公司近期发表在arXiv上的前沿研究《The Sound of Risk: A Multimodal Physics-Informed Acoustic Model for Forecasting Market Volatil…
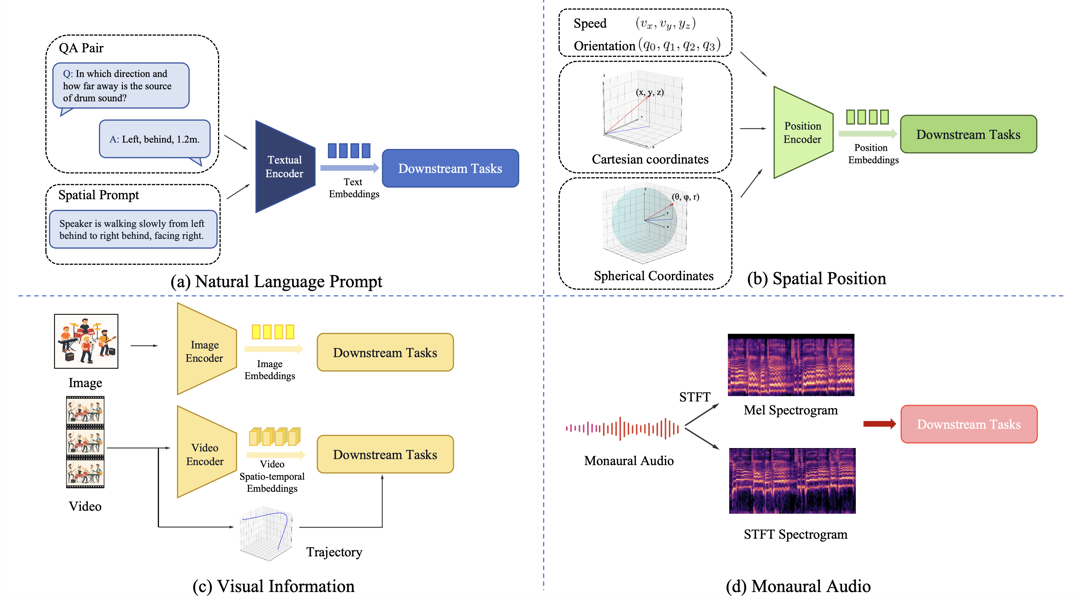
近几年,空间音频从“更高质量到音频”走向“可被理解与生成的三维声场”。它不只是把声音变“立体”,而是让系统理解声源的方位、距离、运动,并能按需生成。在AR/VR、影视、游戏与交互内容的牵引下,研究重心也从传统的信号级处理迈向多模态、可控生成…
谷歌近期发布的Perch 2.0生物声学模型,通过识别海洋生物和鸟类的声音,展示了AI在特定声学领域的巨大潜力。然而,这仅仅是一个开始。与Perch 2.0的专一性不同,声智科技正在打造一个更为宏大且通用的“AI耳朵”,其声音事件和情感识别…
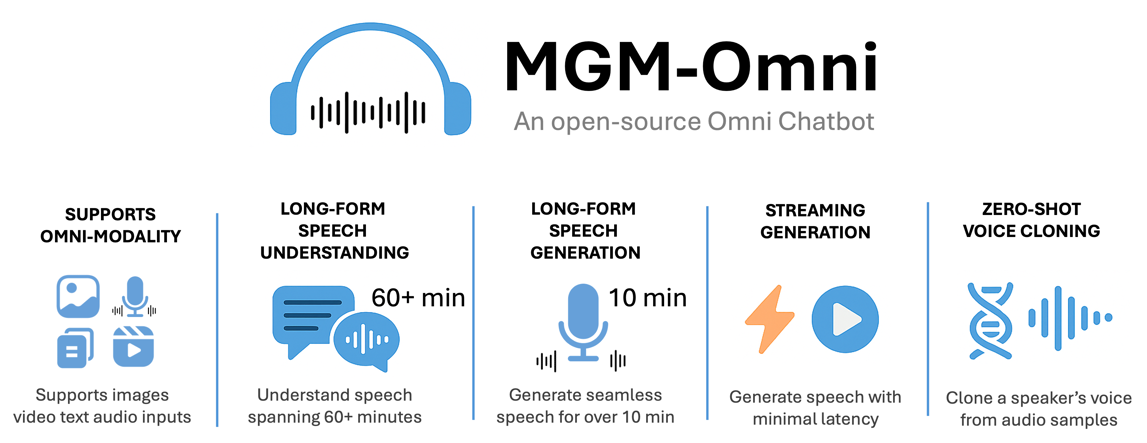
来源丨githubStore MGM-Omni 是一个能够处理文本、图像、视频和语音输入,并能生成文本和语音响应的全能聊天机器人。基于 MiniGemini 和 MiniGemini v2 (Lyra),MiniGemini-Omni (M…
近日,阶跃星辰正式发布开源端到端语音大模型Step-Audio 2 mini,该模型在多个国际基准测试集上取得 SOTA 成绩。 Step-Audio 2 mini将语音理解、音频推理与生成统一建模,在音频理解、语音识别、跨语种翻译、情感与…
