逻辑智能|全球首个语音语言模型开源全家桶 LLaSO 来了

语音语言模型(LSLM)领域长期面临碎片化发展困境:架构路径各异、训练数据私有、评估标准缺失,这些问题严重阻碍了技术进步和公平比较。近日,北京深度逻辑智能科技有限公司推出LLaSO——全球首个完全开源的端到端语音语言模型研究框架,旨在为LS…
17 0 0

语音语言模型(LSLM)领域长期面临碎片化发展困境:架构路径各异、训练数据私有、评估标准缺失,这些问题严重阻碍了技术进步和公平比较。近日,北京深度逻辑智能科技有限公司推出LLaSO——全球首个完全开源的端到端语音语言模型研究框架,旨在为LS…
来源丨AI音频时代 人工智能研究实验室Stability AI正式推出企业级音频生成模型Stable Audio 2.5。也是首款针对企业级用例开发的模型。 Stable Audio 2.5在音频细节处理、生成速度、音乐结构完整性以及功能拓…
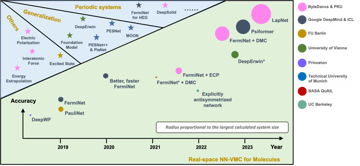
大家好,欢迎来到「AudioCC交我学」专栏! 你是否想过,人工智能不仅能写诗画画、聊天写代码,也能成为科学家的“实验搭子”? 2025年4月10日,我们围绕“AI for Science”展开了一次精彩讲座,聚焦人工智能如何帮助科学家解决…
来源丨AI音频时代 语音技术及数据服务提供商Voices近日推出了一款面向AI训练的角色语音数据集。该数据集包含超过450种角色类型,由专业配音演员参与录制,覆盖了包括1920年代时髦女性、军事教官和老年巫师在内的多种形象。 据发布信息显示…
来源丨开源星探、AIGC Studio MultiTalk 是一款开源的音频驱动多人对话视频生成框架,由MeiGen-AI联合中山大学、美团和香港科技大学研发。MultiTalk在语音与嘴形同步方面达到了SOTA性能,并支持通过prompt…
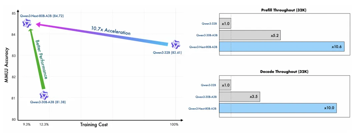
来源丨量子位 Qwen下一代模型架构,抢先来袭! Qwen3-Next发布,Qwen团队负责人林俊旸说,这就是Qwen3.5的抢先预览版。 基于Qwen3-Next,团队先开源了Qwen3-Next-80B-A3B-Base。 模型参数80…
语音小伙伴们看过来,今天给大家介绍个新赛道! 你是否想过,大脑处理语音信号的过程与我们熟悉的语音识别系统有着惊人的相似性? 从时序信号处理到特征提取,从编码解码到多模态融合,脑机接口与语音技术在底层逻辑上竟然如此相通! 今天让我们一起探索这…
来源丨AI音频时代 AI语音技术公司ElevenLabs正式宣布将其AI文生音效模型升级至版本2。此次更新在音效生成的时长、质量与可控性三大维度实现跨越式提升,标志着AI音频创作正式迈入“专业可用”阶段。 特点说明 1、即时生成 几秒钟内开…
