
最新声浪
查看全部 →
电子阅读的未来:集成AI语音克隆以实现多语言音频内容
音频资料通常只以原作语言广泛传播,而翻译工作成本高昂且不普遍。所以,人们一直梦想着能够将流行的音频资料翻译成当地语言。 除此之外,当音频材料被翻译时,它通常是用一种听起来很普通的声音进行的,与书本(文章等)的预期基调完全不符。 而现在,得益…
20 0 0

论文导读丨INTERSPEECH 2024专题(五)
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期是INTERSPEECH 2024专题第五部分,共遴选了7篇论文,覆盖疾病检测、音频鉴伪、语音合成…
14 0 0


英伟达神秘视频基础模型「Cosmos」曝光,数据全靠偷
来源丨机器之心 为了这个视频模型,英伟达每天正在疯狂地爬取相当于 80 年时长的视频数据。 今天,一则关于英伟达要下场做视频模型的消息引爆了 Reddit。 消息源出自外媒 404 Media,据它获得的 Slack 聊天(英伟达的内部聊天…
13 0 0

比OpenAI的Whisper快50%,最新开源语音模型
生成式AI初创公司aiOla在官网开源了最新语音模型Whisper-Medusa,推理效率比OpenAI开源的Whisper快50%。 aiOla在Whisper的架构之上进行了修改采用了“多头注意力”机制的并行计算方法,允许模型在每个推理…
19 0 0


媲美GPT-4o!复旦推出语音模型 SpeechGPT2
SpeechGPT2 是由复旦大学计算机学院开发的一个端到端的语音对话语言模型,类似于 GPT-4o。能够感知并表达情感,并根据上下文和人类指令以多种风格提供合适的语音响应。如说唱、戏剧、机器人、搞笑和低语等。 项目地址:https://0…
14 0 0
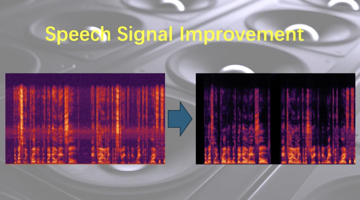
INTERSPEECH2024 | RaD-Net 2:基于因果性蒸馏和复数轴向自注意力机制的两阶段音质修复模型
随着手机、笔记本电脑等智能设备的普及,音频通信系统在人们的日常生活中起到了越来越重要的作用。然而,受硬件等多种因素的限制,通信系统中的语音信号经常因频率响应失真、不连续失真、响度问题、混响和噪声等受到损伤,影响听感。在ICASSP 2024…
7 0 0
