
最新声浪
查看全部 →
ASR纠错迎来新方法:华为提出SS+GL方案,大幅提升命名实体识别准确率

来源丨乐百一家 咱们先聊聊华为这篇论文的核心目标——解决ASR(自动语音识别)里“专有名词老认错”的问题。比如像“ChatGPT”“长江白鲟”这种领域特定的命名实体,ASR(比如Whisper)在通用场景里挺准,但遇到这些词常转错,后续用这…
22 0 0
美团开源 LongCat-Audio-Codec,高效语音编解码器助力实时交互落地
语音大语言模型(Speech LLM)想落地,绕不开一个死结:既要快速理解语音里的语义,又要说出自然的音色,还得实时响应。比如智能音箱 “听不懂” 语音,车载助手 “说” 得像机器人,实时翻译延迟卡半秒。深究根源,全在 “语音 Token…
26 0 0
GPT-5.1发布,OpenAI开始拼情商
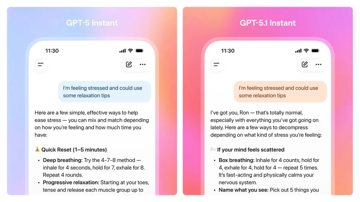
来源丨机器之心 深夜,GPT-5 系列迎来大更新:上线 GPT-5.1 Instant 以及 GPT-5.1 Thinking 模型。 GPT-5.1 Instant:ChatGPT 最常用的模型,更温暖、更智能,也更善于遵循指令的模型。…
25 0 0
阶跃星辰发布首个开源 LLM 级音频编辑大模型 Step-Audio-EditX
来源丨魔塔modelscope社区 近期,阶跃星辰发布了全球首个开源 LLM 级音频编辑大模型 —— Step-Audio-EditX。 该模型能够通过语言指令或迭代方式,精准控制音频的情感、说话风格和副语言特征,并实现零样本文本转语音(Z…
17 0 0
【交我学-17】稀疏注意力机制:原理、挑战与DeepSeek最新NSA技术解析
大家好,欢迎来到「AudioCC交我学」专栏! 一、技术必要性分析 稀疏注意力的发展主要源于三方面需求: 计算效率需求:传统注意力在处理长文档、高分辨率图像等任务时,计算量随长度平方增长,严重制约模型扩展性。 内存优化需求:注意力矩阵的显存…
17 0 0
硅谷热议:最快语音转文字模型
来源丨量子位 最强语音转文字模型,正在硅谷被热议。 直接把“快、 准、全”三个字拉到了新高度。 来自AI语音独角兽公司ElevenLabs,刚刚发布了Scribe v2 Realtime实时语音转文本模型,网友表示:Next-Level。…
30 0 0
Meta开源多语言语音识别系统,支持1600种语言,可轻松扩展新语种!
来源丨新智元、开源星探 Meta发布了Omnilingual ASR系统,一个可自动识别转录1600多种语言语音的AI模型族,让几乎所有人类语言都能被机器「听懂」。 语音识别(ASR)一直是 AI 语音领域的“硬骨头”。在世界上7000多种…
21 0 0