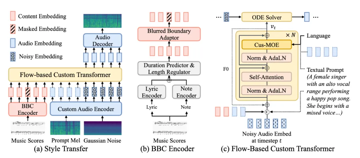
ACL 2025丨TCSinger2:高度可定制化的多语言零样本歌声合成

零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…
17 0 0

零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…

近年来,神经网络偏置(Deep Biasing)方法在上下文语音识别(Contextual ASR)任务中取得了显著进展,其旨在提升模型对实体名称、技术术语等罕见短语的识别能力。当前主流方法多基于浅融合或神经网络偏置技术,将上下文短语中的子…


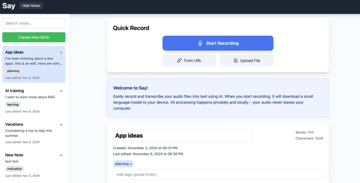
语音转文字(STT)常需云端处理或复杂软件安装,隐私和便利性难以兼得。 Say是一款基于Whisper和Transformers.js的开源浏览器内语音转文字工具,完全本地运行,保护隐私,同时提供实时转录和富文本编辑。 其核心特点包括 •浏…

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…

近日,阿里通义实验室开源了旗下首个音频生成模型ThinkSound,该模型首次将CoT(Chain-of-Thought,思维链)应用到音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,Th…

流式语音识别(streaming ASR)因其低延迟、高效率的特点,适用在诸多“快速出字”的应用中。当前主流的端到端模型包括 CTC、RNN-T 和基于注意力的编码器-解码器(AED)。其中 CTC 凭借结构简单,在流式场景中被广泛采用。为…

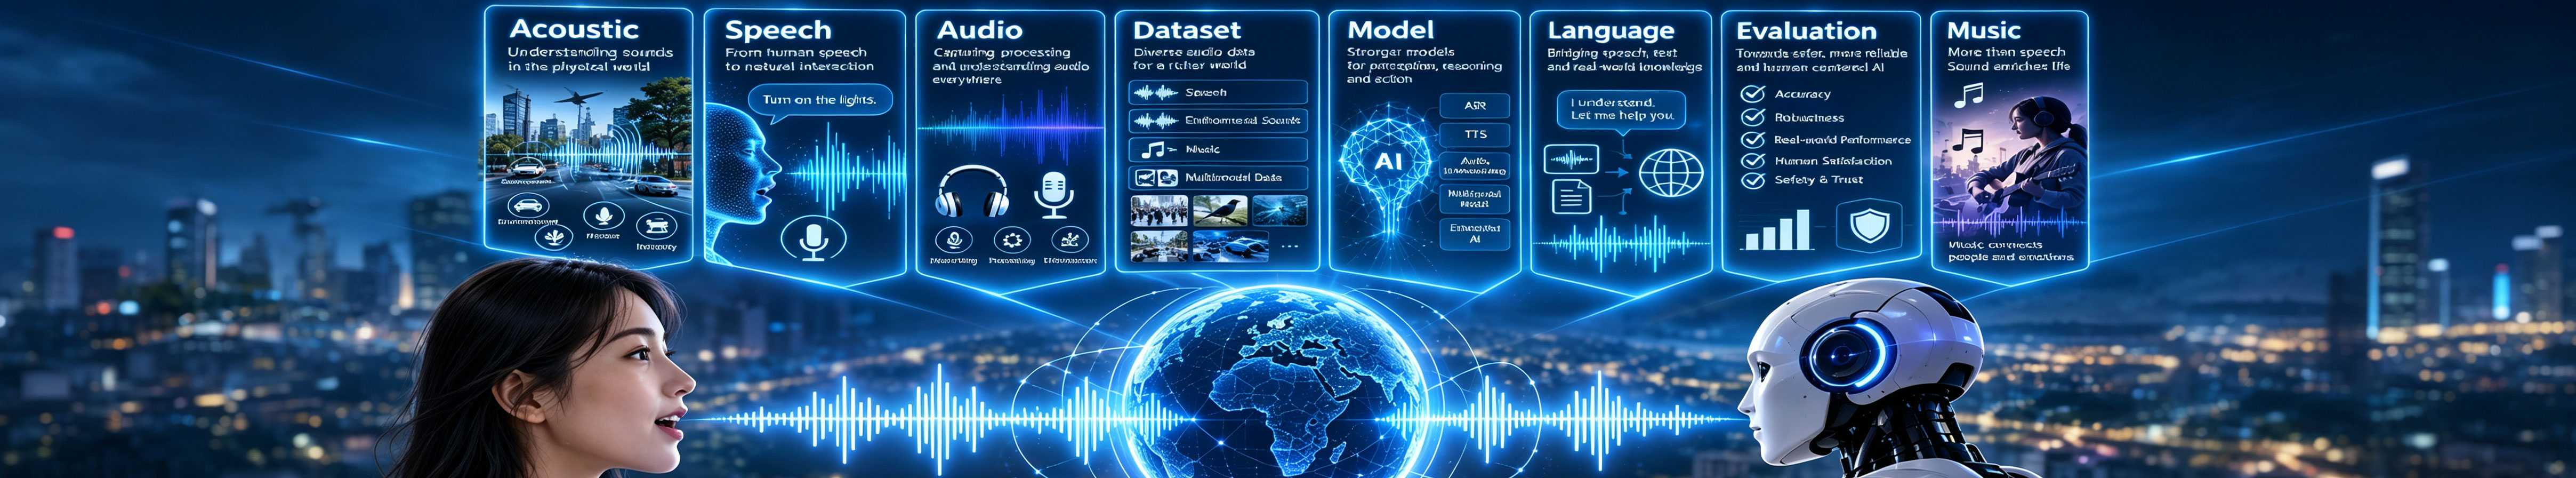
在通用人工智能(AGI)备受瞩目的今天,音频大模型的研究也正快速推进。但相比图文多模态的成熟体系,音频领域仍面临巨大的挑战。不同类型的音频任务——如语音识别、音频事件检测、音乐理解等——往往“各自为政”,难以统一建模。为解决上述问题,西工大…
