INTERSPEECH 2022|基于层级上下文语义信息的多尺度语音合成风格建模
本文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。 人类语音的风格表达是多尺度的,不仅包括全局尺度的情感表达,还包括局部尺度的韵律表达。 而现有关于表现力语音合成的工作只考虑了单一尺度的说话风格。 针对该…
126 0 0

本文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。 人类语音的风格表达是多尺度的,不仅包括全局尺度的情感表达,还包括局部尺度的韵律表达。 而现有关于表现力语音合成的工作只考虑了单一尺度的说话风格。 针对该…
今日论文合集:cs.SD语音10篇,eess.AS音频处理12篇。 cs.SD语音 【1】 Surrogate Gradient Spiking Neural Networks as Encoders for Large Vocabular…
本文由清华大学与香港中文大学合作,面向电子有声读物的自动智能生成,提出了一种跨说话人的语音风格迁移方法。该方法可以在目标说话人缺乏特定朗读风格数据的真实场景下,通过灵活组合音色和风格表征,将朗读风格迁移至任意目标说话人,并最终合成出整体风格…
今日论文合集:cs.SD语音4篇,eess.AS音频处理6篇。 cs.SD语音 【1】MMSpeech: Multi-modal Multi-task Encoder-Decoder Pre-training for Speech Reco…
今日论文合集:cs.SD语音10篇,eess.AS音频处理10篇。 cs.SD语音 【1】 Topological Data Analysis for Speech Processing 标题:语音处理中的拓扑数据分析 链接:https:/…
从模型体验到开发训练,本文将演示如何通过modelscope魔搭体验达摩院预训练模型,并手把手演示定制一款语音合成模型的训练过程。 目前达摩院语音实验室在ModelScope魔搭社区已经上线了13个语音合成模型,其中男女声发音人模型各4个,…
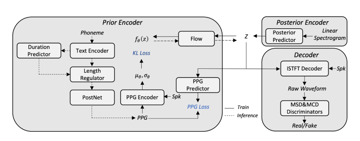
文章来源于音频语音与语言处理研究组,作者宋堃 当前主流的实现小样本音色克隆的可靠方式是说话人自适应(speaker adaption)技术,该技术通常通过在预训练的多说话人文语转换 (TTS) 模型上使用少量的目标说话人数据进行微调而获得目…
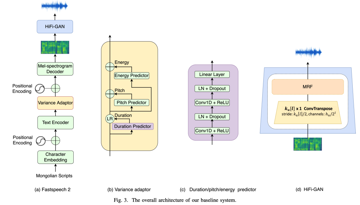
文章来源于智能语音新青年,作者ttslr 本次分享内蒙古大学蒙古文信息处理重点实验室、蒙古文智能信息处理技术国家地方联合工程研究中心及语音理解与生成实验室 (S2LAB) (https://ttslr.github.io/index_S2G…
今日论文合集:cs.SD语音13篇,eess.AS音频处理13篇。 cs.SD语音 【1】 Controllable speech synthesis by learning discrete phoneme-level prosodic…
Clustering by Fast Search and Find of Density Peaks(CFDP) - 发表于2014 science期刊 聚类算法,作为机器学习里常用的一种无监督方法,一直以来都受到很大的关注。聚类算法,是…