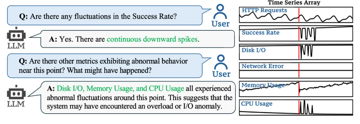
字节跳动&清华大学开源多模态时序大模型ChatTS,可实现时序数据对话与推理

该工作由字节跳动 ByteBrain 团队 × 清华大学合作完成。第一作者为清华大学三年级博士生谢哲,主要研究方向为时序多模态 LLM、异常检测和根因定位。第二作者和第三作者分别为李则言和何晓,均来自字节跳动。通讯作者分别为字节跳动研究科学…
22 0 0

该工作由字节跳动 ByteBrain 团队 × 清华大学合作完成。第一作者为清华大学三年级博士生谢哲,主要研究方向为时序多模态 LLM、异常检测和根因定位。第二作者和第三作者分别为李则言和何晓,均来自字节跳动。通讯作者分别为字节跳动研究科学…

来源丨夕小瑶科技说 当前具身智能研发正面临“双重枷锁”:一方面,真机验证成本高、仿真偏差大,制约策略验证效率;另一方面,海量真机数据尚未构建基于轨迹扩增的高效利用机制,导致数据未被充分利用,制约了模型的持续进化。为打破这一困局,智元机器人在…


语音情感识别(Speech Emotion Recognition, SER)通过分析语音信号来判断说话者的情绪状态,其中充分利用音频信息至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种基于增强残差集成与协同注意力两阶…
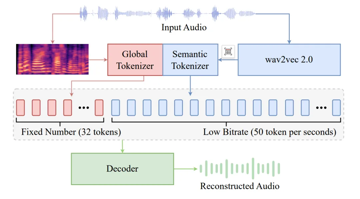
在语音合成(Text-to-Speech, TTS)领域,传统的 TTS 系统主要包括自回归(Autoregressive, AR)模型、非自回归(Non-Autoregressive, NAR)模型以及结合两者优点的混合范式(AR+NAR…
昨天,火山引擎旗下豆包团队推出的豆包·语音播客模型,以三大核心技术突破重塑播客内容生产逻辑。这一模型基于流式技术实现文本到双人对话式播客的即时转换,生成的自然语音在流畅度、情感表现和语义连贯性上均达到专业录制水准,甚至能通过深度搜索功能在5…

在复杂环境中保持清晰语音感知一直是助听设备与消费级耳机的核心挑战。传统主动降噪(ANC)技术虽能抑制环境噪声,但会无差别削弱所有声音,导致用户难以听清目标方向的语音(如对话者)。近年来,开放式耳机因佩戴舒适、减少耳道堵塞效应等优势备受关注,…

