当音乐生成跑在了评测前面:用「组合式多模态指令」为音乐奖励模型立一把标尺

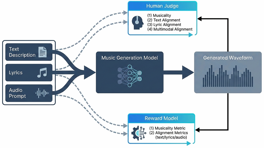
近年来,以Suno、Mureka、YuE、ACE-Step 等为代表的音乐生成模型迅速演进,其输入条件已经从单一的文本描述,扩展为文本、歌词与参考音频任意组合的多模态指令。然而,用来判断「单条生成结果到底好不好」的评测手段,却相对滞后:传统…
30 0 0

近年来,以Suno、Mureka、YuE、ACE-Step 等为代表的音乐生成模型迅速演进,其输入条件已经从单一的文本描述,扩展为文本、歌词与参考音频任意组合的多模态指令。然而,用来判断「单条生成结果到底好不好」的评测手段,却相对滞后:传统…
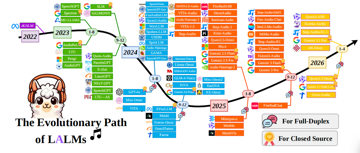
它听得懂情绪、辨得出身份、甚至能模仿你说话——但你敢信任它吗? “你今天看起来有点累。”当你对手机说出这句话,它不仅能听懂字面意思,还能从你的语速、语调、呼吸节奏中判断——你是真的疲惫,还是在强撑?这不是科幻。这是大型音频语言模型正在实现的…
本期分享国防科技大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的音频表示质量评估方面的工作。 Unifying Variables in Neural Sc…
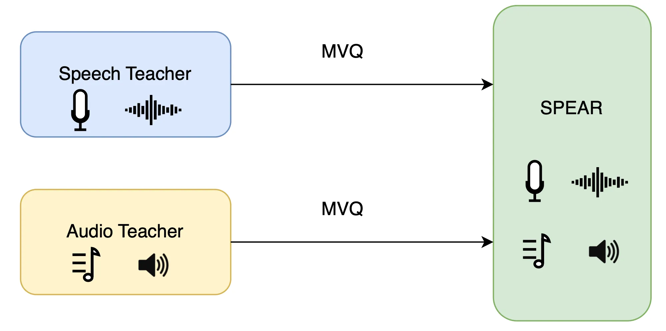
录取信息:ICML 2026 论文标题:SPEAR: A Unified SSL Framework for Learning Speech and Audio Representations 作者:Xiaoyu Yang, Yifan Y…
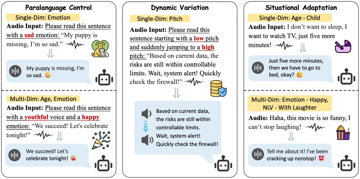
来源丨paperweekly 问题可能不在语言能力本身,而在那些更难被建模的东西:语气、情绪、停顿、潜台词,以及人与人交流时微妙的“社交感”。而最近,一篇来自南京大学与小米的论文,开始系统地评测这些副语言能力。 论文标题:SpeechPar…
以下文章来源于AI语音AI思考 如果看过我最早的文章,你可能记得我曾说过:限制语音交互发展的主要因素通常并非技术,而是场景。例如,在办公室等公开场合,人们通常不会选择与机器进行语音对话,也不会频繁使用语音输入;而在车内、家中等相对私密的环境…