Interspeech2025丨FlowSE — 基于流匹配的高效语音增强

在语音通信与人机交互场景中,噪声始终是语音质量和识别准确率的最大干扰之一。语音增强(Speech Enhancement, SE)技术旨在从嘈杂的语音中恢复出清晰、自然的干净语音,在语音通话、助听器、语音识别前端等应用中发挥着至关重要的作用…
25 0 0

在语音通信与人机交互场景中,噪声始终是语音质量和识别准确率的最大干扰之一。语音增强(Speech Enhancement, SE)技术旨在从嘈杂的语音中恢复出清晰、自然的干净语音,在语音通话、助听器、语音识别前端等应用中发挥着至关重要的作用…
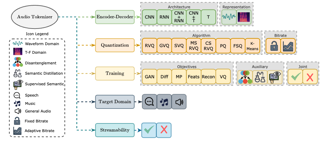
语音是最贴近人类本质的沟通方式,不仅传达语言,还承载情感、声纹、语气与节奏,展现说话者的个性与意图。在大语言模型(LLMs)推动下,语音语言模型迅速演进。离散语音 token(Discrete Speech Tokens) 正成为构建语音表…
随着人工智能(AI)在各个领域的引入和融合,技术的发展速度可以说是非常快的。它已经从幕后工具逐渐转变为界面本身。我们见证了从只能勉强拼凑出连贯句子的聊天机器人,到能够进行完整播客对话的 AI 代理的转变,这些 AI 代理帮助人们学习、思考,…
谷歌的Magenta团队推出了Magenta RealTime(Magenta RT),这是一种开放权重的实时音乐生成模型,为生成式音频带来了前所未有的交互性。Magenta RT根据Apache 2.0许可证发布,可在GitHub和Hug…
来源丨图灵AI云 Streaming-Kokoro是一款基于网络的文本转语音应用程序,利用Kokoro-82M模型在浏览器中生成高质量的语音音频。 它完全在浏览器中运行,无需任何服务器端处理或 API 调用,是一个真正开源、隐私保护、零服务…
来源丨21db声学人 随着生成模型的快速发展,4D场景生成技术(即动态3D场景生成)在近年来取得了显著进展。4D生成技术能够从任意相机视角生成时空一致的渲染效果,广泛应用于增强现实(AR)、虚拟现实(VR)、机器人技术和自动驾驶等领域。 尽…
来源丨新智元 最近,来自NUS、UT Austin等机构的研究人员创新性地提出了一种「拖拽式大语言模型」(DnD),它可以基于提示词快速生成模型参数,无需微调就能适应任务。不仅效率最高提升12000倍,而且具备出色的零样本泛化能力。 现在的…
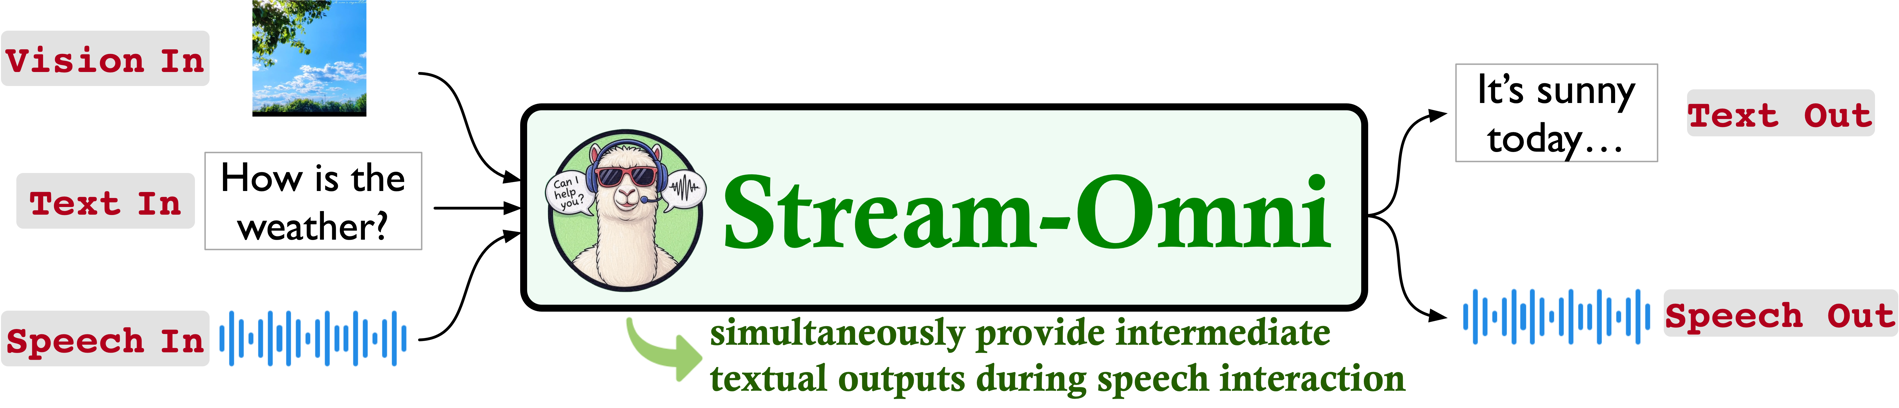
Stream-Omni是由中国科学院计算技术研究所智能信息处理重点实验室、中科院人工智能安全重点实验室及中国科学院大学联合推出的大型多模态语言模型。该模型对标GPT-4o,实现了文本、视觉、语音三种模态的无缝融合交互。 GitHub仓库:h…