180万小时数据训练,VoxCPM 1.5开源:支持全量微调,精准复刻真人声

来源丨PaperWeekly 180 万小时、44k 高保真、支持全量微调——刚刚开源的 VoxCPM 1.5,技术细节全解密。 最近,面壁技术团队发布了 VoxCPM 1.5 版本,在持续优化开发者开发体验的同时,也带来了多项核心能力升级…
21 0 0

来源丨PaperWeekly 180 万小时、44k 高保真、支持全量微调——刚刚开源的 VoxCPM 1.5,技术细节全解密。 最近,面壁技术团队发布了 VoxCPM 1.5 版本,在持续优化开发者开发体验的同时,也带来了多项核心能力升级…
本文由知乎作者Oliver投稿,采用第一人称视角撰写 语音增强技术已经发展了好多年了,但是目前各说各的好或者是技术保密。那么现在语音增强技术到底发展到一种什么程度了呢?未来的趋向又在什么地方? 2022年入职后,在mentor的指导下我开始…
近日智谱正式发布工业级语音合成系统 GLM-TTS,并在 Hugging Face 和 ModelScope 上开放模型权重。 基于在数据筛选、基础模型结构、精品音色监督微调(SFT)范式和强化学习(RL)范式等多方面创新,GLM-TTS…
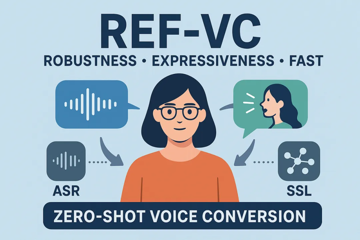
语音转换(Voice Conversion, VC)旨在在不改变语言内容的情况下,将源说话人的语音转换为目标说话人的语音,广泛应用于电影配音、虚拟人、语音聊天等场景。然而在真实应用场景中,VC 系统面临两大挑战。 环境噪声:用户录音往往嘈杂…
老师信息 苗晓晓,昆山杜克大学计算机科学系助理教授,研究方向包括语音安全与智能语音处理。她于2021 年获得中国科学院大学/中国科学院声学研究所信号与信息处理博士学位,并于 2021 年至 2023 年在日本国立信息学研究所(NII)从事博…
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
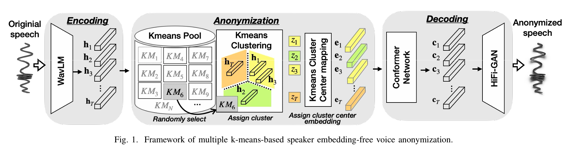
语音匿名化(Voice Anonymization)旨在在保留语义和情感信息的同时去除说话人的身份特征。现有基于深度学习的主流方法通常依赖显式说话人嵌入模型(Speaker Embedding Model)来提取和替换说话人特征,但这类方法…
声学回声消除(Acoustic Echo Cancellation, AEC) 作为语音通信系统的核心预处理模块,其核心任务是从麦克风采集信号中实时分离近端语音(near-end speech)与远端回声(far-end echo)。该技术…
