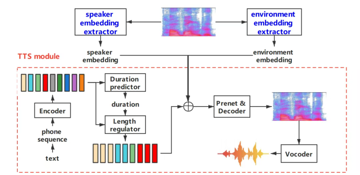
【交我学-5】环境感知语音合成:从“干净”走向“真实”

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
11 0 0

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
题目:MDPE: A Multimodal Deception Dataset with Personality and Emotional Characteristics 作者:蔡聪,梁山,柳雪飞,朱康,温正棋,陶建华,解衡,崔济舟,马一…
来源丨今日声学 近日,Meta Platforms正式完成对人工智能初创公司WaveForms AI的收购,后者专注于情感识别与音频模拟技术的研发。 成立于2023年12月的WaveForms AI此前已完成4000万美元A轮融资,由硅谷顶…
论文题目:Sequence-to-Sequence Neural Diarization with Automatic Speaker Detection and Representation 作者列表:Ming Cheng(程铭), Yu…
来源丨AI音频时代 AI音乐创作领域又迎来了一个重磅竞争对手!ElevenLabs公司于2025年8月5日正式发布了其最新研发成果——Eleven Music,一款强大的文字转音乐AI模型。据称,这款工具不仅能够生成任意风格的录音室级别音频…
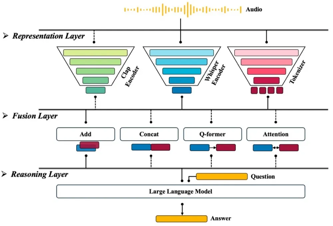
近日,2025年IEEE AASP举办的DCASE挑战赛(Challenge on Detection and Classification of Acoustic Scenes and Events)落幕。作为目前声音事件领域最权威的竞赛…
来源丨新智元 擅长「种草」的小红书正加大技术自研力度,两个月内接连开源三款模型!最新开源的首个多模态大模型dots.vlm1,基于自研视觉编码器构建,实测看穿色盲图,破解数独,解高考数学题,一句话写李白诗风,视觉理解和推理能力都逼近Gemi…
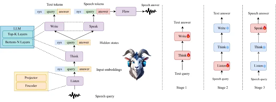
来源丨中国电信人工智能研究院 同样的文字,在不同语境下,根据说话人的语速、语气、语调的差异,会表达完全不同的意思,代表不同的情绪、态度和意图。 这项应用的背后,是中国电信人工智能研究院(TeleAI)研究的一项新的技术路径——超语义语音学(…
