
声浪

AI配音新王者!快手AudioGen-Omni:视频喂给它,歌声/语音/音效秒出,唇形精准到帧!

近日,中国矿业大学与快手科技联合研发的AudioGen-Omni模型,以面向音频-语音-歌曲三合一生成的统一多模态扩散Transformer架构,实现了高保真音频、语音与歌曲的生成,并达成与输入视频的深度时序同步。 论文链接:https:/…
26 0 0
训练200万小时!OpenAI开源GPT-oss,AI Agent专属模型、可商用
来源丨AIGC开放社区 今天凌晨1点30,OpenAI开源了大模型GPT-oss,一共有1200亿和200亿两种参数,支持Apache 2.0商业化。 开源地址: https://github.com/openai/GPT-oss http…
19 0 0
MIMO-TSVAD:支持模态缺失的音视频说话人日志新框架 —— 武汉大学/昆山杜克大学团队成果发表于 IEEE T-ASLP
论文题目:Multi-Input Multi-Output Target-Speaker Voice Activity Detection For Unified, Flexible, and Robust Audio-Visual Spe…
13 0 0
阿里开源Qwen-Image,中文最好模型,精准搞定复杂字体排版,硬刚字节OpenAI
来源丨AIGC开放社区 今天,阿里开源了最新文生图模型 Qwen-Image 。 Qwen-Image是一个200亿参数的MMDiT模型,可生成写实、动漫、赛博朋克、科幻、极简、复古、超现实、水墨等几十种类型的图片,支持图片的风格迁移、增删…
13 0 0
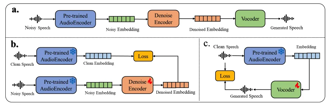
小米开源声音理解大模型 MiDashengLM-7B
来源丨小米技术 音频理解是构建全场景智能生态的关键领域,在智能座舱、家居交互等场景均有广泛应用。今天小米发布和全量开源了 MiDashengLM-7B 模型。MiDashengLM-7B 基于 Xiaomi Dasheng 作为音频编码器和…
31 0 0
自变量机器人丨招聘 VLA大模型实习生
【职位描述】 1.参与研发前沿的机器人大模型 (vision language action model). 包括但不限于机器人动作表征,多模态表征,vla大模型架构设计和训练等 2.跟进并调研国内外前沿的vla大模型技术,协助团队完成相关…
37 0 0
自变量机器人丨招聘语音大模型算法实习生
【公司介绍】 自变量机器人是国内唯一实现端到端统一具身智能大模型商业化的具身智能创业公司,技术水平和融资规模均达到国内TOP水平,一年内完成七轮亿元级融资,其中包含美团独家投资A轮,君联资本、光速光合、北京机器人产业基金、云启资本、广发信德…
46 0 0