
声浪

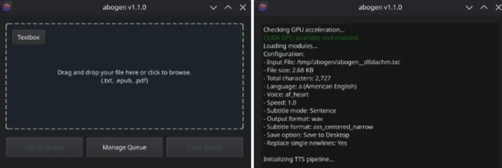
刚刚开源的TTS神器,Kokoro-82M驱动,支持ePub/PDF/TXT,跨平台!

文本转语音(TTS)工具的需求现在是越来越多,尤其是在生成高质量有声书、配音和同步字幕的场景中。传统TTS工具要么依赖云端API,存在隐私风险,要么生成速度慢、语音不自然。 Abogen是最近刚开源的一款新型 TTS 工具,通过Kokoro…
21 0 0
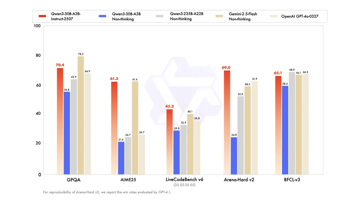
Qwen3-30B-A3B新版本发布,更轻更好用,提升指令遵循与长上下文理解能力!
通义千问Qwen团队宣布本周进入“Flash week”,第一弹推出了更新版本的Qwen3-30B-A3B 非思考和思考模式,命名为Qwen3-30B-A3B-Instruct-2507 和 Qwen3-30B-A3B-Thinking-2…
17 0 0
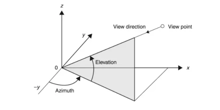
基于 SRP-PHAT 的声源定位算法
在混响环境中进行说话人定位和自动跟踪是一项具有挑战性但又在众多基于音频的应用中常常需要完成的任务,例如免提手机、语音识别以及电话会议等。前面介绍的使用TDOA进行声源定位方法,在强混响或多路径环境中,互相关函数会出现多个峰值,TDOA 法可…
15 0 0
邱锡鹏团队开源MOSS-TTSD!百万小时音频训练,突破AI播客恐怖谷
来源丨机器之心 当前的文本到语音(TTS)模型在单句或孤立段落的语音生成效果上取得了令人瞩目的进展,合成语音的自然度、清晰度和表现力都已显著提升,甚至接近真人水平。不过,由于缺乏整体的对话情境,这些 TTS 模型仍然无法合成高质量的对话语音…
24 0 0
李宏毅与NVIDIA 联手打造 DeSTA2.5-Audio:证明旧方法正在“毁掉”你的语音语言模型
论文标题:DeSTA2.5-Audio: Toward General-Purpose Large Audio Language Model with Self-Generated Cross-Modal Alignment Arxiv:h…
26 0 0
IEEE TASLP|利用LLM改进口音语音识别的多模态多粒度生成式纠错与混合LoRA专家方法
语音识别(ASR)作为可以准确高效转录语音的技术,在当今社会中扮演着越来越重要的角色。当前语音识别已经取得了长足进步,但是当遇到不利语音条件时,识别错误率急剧升高。口音是说话人受到教育背景、地域或母语影响而偏离标准发音规范的情况,在现实世界…
16 0 0