
声浪

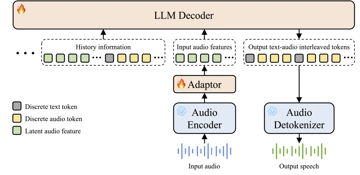
Step-Audio 2:端到端音频大语言模型,实现行业级理解与对话能力

Step‑Audio 2是由StepFun团队开发的多模态大语言模型,可直接从原始音频输入理解语义与副语言信息,并生成连贯的文本与音频响应。 模型通过隐向量音频编码器、强化学习(RL)与检索增强生成(RAG)机制,引入工具调用(如 Web…
25 0 0
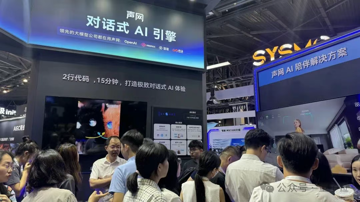
声网发布新版对话式 AI 引擎,三大创新功能重塑人机交互体验
近日,声网在2025世界人工智能大会发布新版对话式 AI 引擎,该版本新增声纹识别、数字人与视觉理解三项功能,实现对话式 AI 音视频交互体验的全新升级。同时,口袋 AI 毛绒宠物—芙崽 Fuzozo、家庭陪伴机器人—赋之 EBO Air…
13 0 0
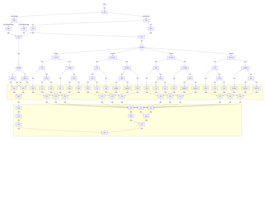
音元分析流程

```mermaid graphTB A([开始])-->|输入|B[音节] B-->|析取音节的音调|C1[节调] B-->|析取音节的音质|C2[节质] C1-->|切分与声母联结的调段|D1[首调] C1-->|切分与声母联结的调段|…
56 1 1
HONOR荣耀 | 招聘音频算法工程师
职位描述 1. 从事音频领域的算法研究及开发工作,包括语音增强(AEC、ANC、BSS等)、智能语音(唤醒、多命令词、声纹识别、场景检测、事件检测等)、影音音效(空间音频、smartPA)等。 2. 负责音频算法的预研,交付等工作 岗位要求…
58 0 0
阿里巴巴-通义实验室-语音唤醒算法专家
【职位描述】 1. 负责通义实验室的语音唤醒等算法研发,通过深入理解全链路技术挑战和推动语音前后端协作,打造行业领先的语音交互算法。 2. 持续关注行业前沿动态,通过专利申请、论文和技术报告等形式提升团队的技术影响力。 【任职要求】 1.…
47 0 0
OmniAvatar:夸克技术团队 x 浙江大学联合开源,音频驱动全身视频生成模型
近期,夸克技术团队和浙江大学联合开源了OmniAvatar,这是一个创新的音频驱动全身视频生成模型,只需要输入一张图片和一段音频,OmniAvatar即可生成相应视频,且显著提升了画面中人物的唇形同步细节和全身动作的流畅性。此外,还可通过提…
13 0 0
重要时间调整通知丨2025年CCF先进音频技术竞赛
由中国计算机学会主办、CCF语音对话与听觉专委会承办、语音之家协办、华为终端有限公司独家合作的CCF先进音频技术竞赛已正式启动,大赛旨在推动国内高等院校及科研院所在音频技术领域的专业人才培养,支持学生科技创新,选拔优秀人才。 现因赛事安排调…
12 0 0