TeleAI-AIGC 音频/音乐多模态算法实习生

职位描述: 1.研发行业领先且实用的音频/音乐多模态算法,包括但不限于文生音频/音乐、视频音效/音乐生成、音频/音乐编辑、基于歌词/发音人 prompt/哼唱等条件的歌曲生成、交互式音频/音乐内容创作、音乐信息检索等方向; 2.跟进并调研国…
45 0 0

职位描述: 1.研发行业领先且实用的音频/音乐多模态算法,包括但不限于文生音频/音乐、视频音效/音乐生成、音频/音乐编辑、基于歌词/发音人 prompt/哼唱等条件的歌曲生成、交互式音频/音乐内容创作、音乐信息检索等方向; 2.跟进并调研国…
同声传译,被视为“翻译界的巅峰技能”。它需要译者在数秒的极短时间内转换语言,边“听”边“说”,要求极高。因此,对翻译技术研究者来说,同传一直是最具挑战的方向。 今天,字节跳动 Seed 团队正式发布端到端同声传译模型 Seed LiveIn…
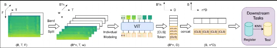
近期,来自清华大学、上海交通大学、北京华控智加科技有限公司和华北电力大学的研究者联合发布首个多模态工业信号基座模型FISHER,采用搭积木的方法对异质工业信号进行统一建模。目前技术报告和权重均已开源,欢迎使用! 论文链接:https://a…
7月23日,夸克健康大模型在业界引起广泛关注:其成功通过了中国12门核心学科的主任医师笔试评测,成为国内首个完成此项专业考核的AI大模型。这一成果不仅凸显了AI在严肃医疗和C端的应用潜力,也引发了行业对其背后技术逻辑与工程实践的深入探讨。…
来源丨量子位 李沐老师终于带着他的手搓语音大模型教程回归了,一千万小时音频数据训练的TTS,效果秒杀一众商业&开源的TTS。 本期视频不讲论文,李沐老师来手把手教大家怎样玩转他们团队最新研发的Higgs Audio V2模型,不仅能处理文本…
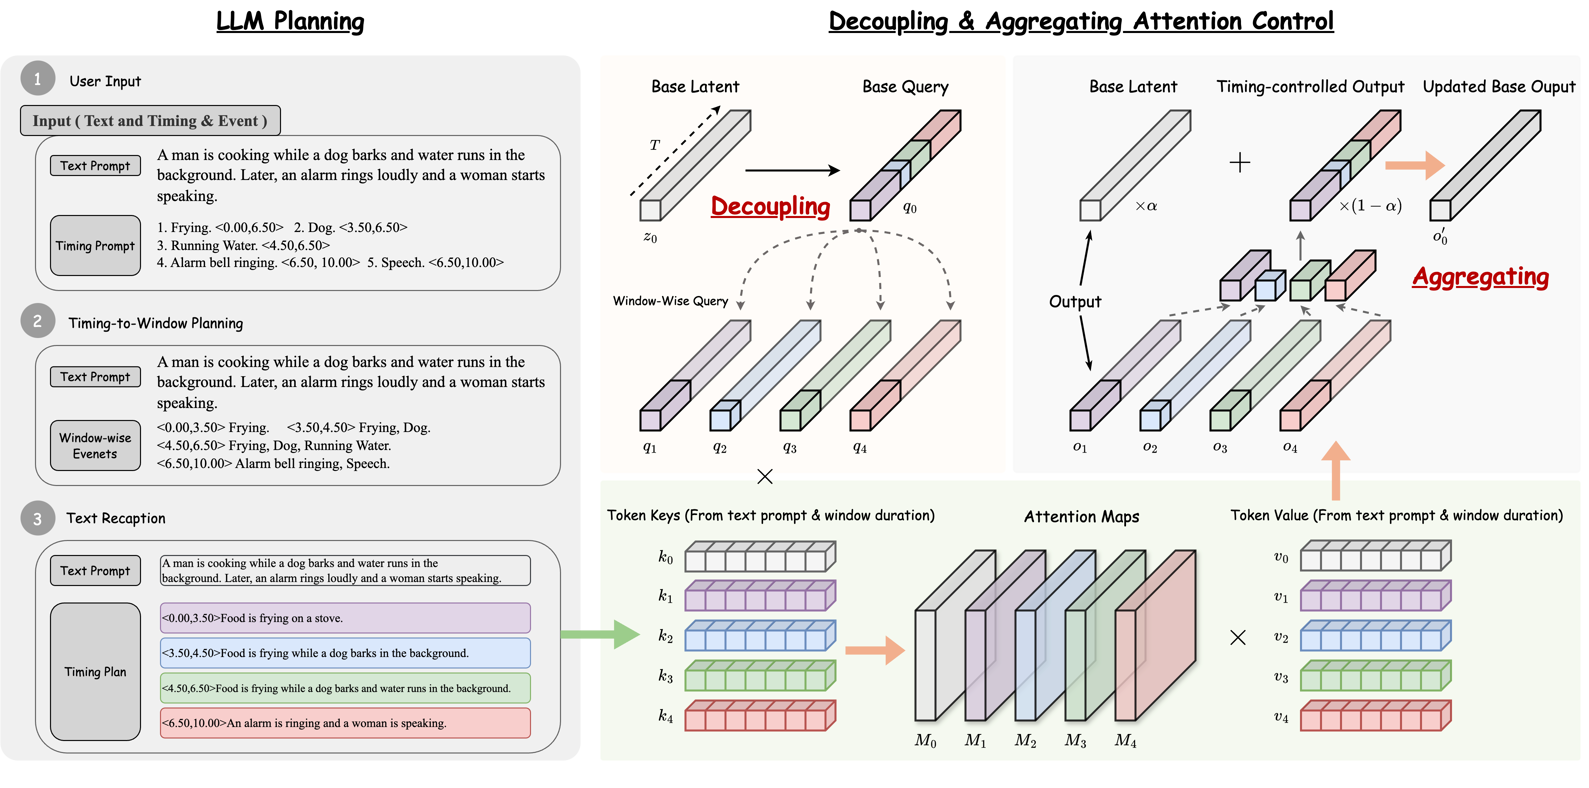
文生音频系统(Text-to-audio generation, T2A)在生成模型的持续发展下取得了显著的进展。然而,由于精确时间对齐的音频-文本数据对在质量和数量上的限制,现有 T2A 系统在面对包含精确时间控制的复杂文本提示时表现仍然…
这可不是什么未来科技的遥远设想,而是Tesla车主 Kim 与其车载 AI Grok 之间的一次真实互动。在即将开始线上会议前,仅凭一句指令,Grok 就能理解用户意图、规划充电路径、选择充电设施,并自主执行整个补能过程。这种跨越“人—车—…
当前视频到音频(Video-to-Audio, V2A)模型可以从视觉输入中生成逼真的背景音频,但它们大多忽略了语音在视频音轨中的关键组成部分。近期,西工大音频语音与语言处理研究组(ASLP@NPU)联合巨人网络、University of…
