sherpa-onnx:AI 语音界的瑞士军刀

语音开源模型这么多,你还在为如何部署烦恼吗?各种模型环境各式各样,你还在为安装环境晕头转向吗?老板说隐私很重要,要出一个离线的demo,你还在犹豫不知如何下手吗?语音那么多任务,又是vad,又是说话人,还得做识别合成,你还在为组合方案费尽心…
37 0 0

语音开源模型这么多,你还在为如何部署烦恼吗?各种模型环境各式各样,你还在为安装环境晕头转向吗?老板说隐私很重要,要出一个离线的demo,你还在犹豫不知如何下手吗?语音那么多任务,又是vad,又是说话人,还得做识别合成,你还在为组合方案费尽心…
今日,QwenTeam 正式发布了全新一代多模态视觉语言模型 ——Qwen3-VL 系列。这是 Qwen 家族迄今为止最强大的视觉语言模型,在视觉感知、跨模态推理、长上下文理解、空间推理和智能代理交互等多个维度全面提升。旗舰开源模型Qwen…
会议简介 全国人机语音通讯学术会议是国内语音领域广大专家、学者和科研工作者交流最新研究成果,促进该领域研究和开发工作不断进步的重要舞台。该系列会议自1990年开创以来已成功召开了十九届。2025年第二十届全国人机语音通讯学术会议(Natio…
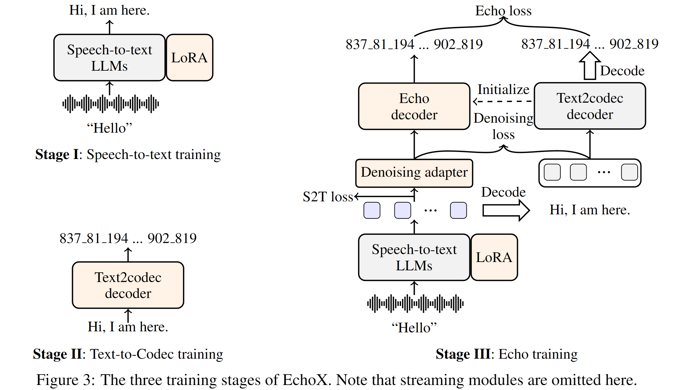
语音到语音大模型(SLLM)火了,但你是否也发现:一旦从“文字”换成“开口说话”,模型的知识与推理能力就开始出现了退化?这并不是错觉,而是“声学-语义鸿沟”在作怪。本文带你看一篇来自香港中文大学(深圳)李海洲教授/王本友教授团队发布的新模型…
来源丨新智元 DeepSeek最新模型DeepSeek-V3.1-Terminus来了!此前在输出中随机掺入「极」字的问题得到显著缓解,Humanity's Last Exam成绩也较V3.1提升1/3!Terminus这个名字是否在暗示D…
几个小时前,阿里一次更新了3个大模型,分别是 开源的全模态大模型 Qwen3-Omni 开源的图像编辑大模型Qwen-Image-Edit-2509 不开源的语音合成大模型 Qwen3-TTS 本次发布的3个模型均为多模态大模型,可以说阿里…
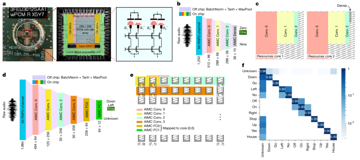
在最新发表在Nature上的一项研究中,特温特大学(University of Twente)与 IBM Research Europe、丰田汽车欧洲公司(Toyota Motor Europe)合作,提出了一种新型“物理计算”语音识别方法…
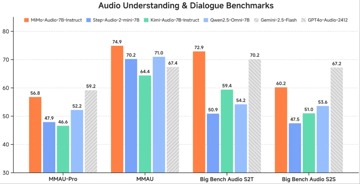
刚刚,小米正式开源首个原生端到端语音模型Xiaomi-MiMo-Audio,该模型参数规模70亿,预训练数据达到超1亿小时,且在开源模型中的语音智能和音频理解基准测试中都实现了SOTA,在多项测试超越同参数量开源模型、谷歌Gemini-2.…
