让对话更自然:NTPP模型用双声道音频学习革新语音对话语言建模

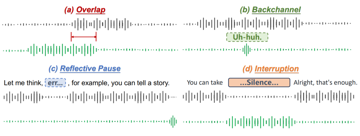
当前,尽管语音基础模型 (Speech Language Model (SLM)) 在模拟人类对话方面取得了显著进展,但如何让机器真正理解并参与到自然、流畅、实时的口语互动中,尤其是在两人对话场景下,仍是一个巨大挑战。现有方法往往难以充分利…
19 0 0

当前,尽管语音基础模型 (Speech Language Model (SLM)) 在模拟人类对话方面取得了显著进展,但如何让机器真正理解并参与到自然、流畅、实时的口语互动中,尤其是在两人对话场景下,仍是一个巨大挑战。现有方法往往难以充分利…
多说话人对话识别是语音处理领域中最具挑战性的问题之一,尤其准确识别重叠语音区域极具挑战。多说话人语音重叠不仅涉及语音片段的重叠,还涉及说话人表征的重叠。有效应对这些挑战对于说话人分离、语音识别以及多说话人对话系统等应用至关重要 。重叠语音检…
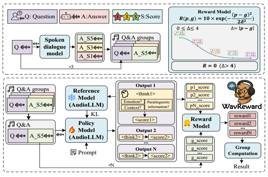
近期,浙江大学联合阿里巴巴通义实验室发表了一篇题为“WavReward: Spoken Dialogue Models With Generalist Reward Evaluators”的论文。该论文提出了一种基于音频理解大模型Qwen2…
分享上海交通大学 X-LANCE 跨媒体语言智能实验室6篇被interspeech2025录用论文。 01、LSCodec: Low-Bitrate and Speaker-Decoupled Discrete Speech Codec
来源丨新智元 智源统一图像生成模型OmniGen2发布后,立刻在AI图像生成领域掀起巨响,多模态技术生态进一步打通。才一周,GitHub星标就已经破了2000,X上的话题浏览数直接破数十万。 刚刚,统一图像生成模型OmniGen2携重大升级…
低资源语音识别(ASR)长期面临两大核心挑战:高质量标注数据稀缺与高昂的计算需求,这在泰语等特定语言中尤为突出。现有解决方案往往受限于大规模、精确标注语料的获取难度,以及大模型(LLM)固有的计算负担。近期,西北工业大学音频语音与语言处理研…
本文由清华大学与香港中文大学、腾讯AI Lab合作,提出了基于大语言模型(LLM)的通用目标音频分离方法:UniSep,实现了对任意混合音频的目标分离。与以往只针对单一领域或单一源的分离工作不同,UniSep支持任意类型音频的目标分离。通过…