NCMMSC 2026 | ChinaVoices Challenge 2026:数据、任务、基线与方法总结

中文语音交互不仅需要处理普通话,也需要面对丰富的地域方言。对于一段方言语音,系统既要判断“说的是哪种方言”,也要准确识别“说了什么”。然而,现有研究采用的方言类别、训练资源和测试集并不统一,系统性能难以直接比较。 近期,西工大音频语音与语言…
算法资讯
23 0 0

中文语音交互不仅需要处理普通话,也需要面对丰富的地域方言。对于一段方言语音,系统既要判断“说的是哪种方言”,也要准确识别“说了什么”。然而,现有研究采用的方言类别、训练资源和测试集并不统一,系统性能难以直接比较。 近期,西工大音频语音与语言…
近日,EMNLP 2026正式公布录用结果,本期分享阿里 Token Foundry Qwen Audio 团队中稿的 3 篇论文,涵盖视频到音频生成、大语言模型推理增强、神经编解码语音合成三大前沿方向。 本次入选的 3 篇论文分别围绕跨模…
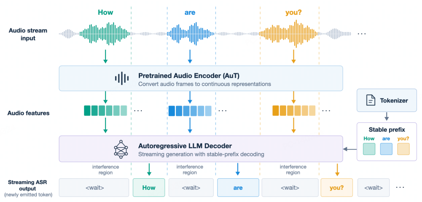
做过实时语音识别的人,大概率都见过这样一种场景: 你刚说完半句话,屏幕上的字幕已经出来了,但再多说几个字,前面的内容突然被改掉。字幕一会儿增加、一会儿回滚,甚至整句话重新刷新。如果只是看字幕,这可能只是“有点闪”。但当ASR的输出开始直接连…
为了推动语音对话与听觉领域的发展,加强委员之间的交流与合作,扩大语音对话与听觉专业委员会在国内外的影响力,中国计算机学会(CCF)语音对话与听觉专业委员会将于2026年11月5日至8日在珠海横琴召开专委会学术年会与年度工作会议,并进行委员纳…
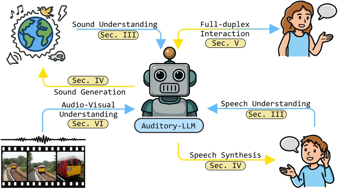
近日,清华大学电子工程系联合Google DeepMind、NVIDIA、剑桥大学等机构的研究人员,在期刊《自然·机器智能》(Nature Machine Intelligence)发表题为《迈向通用听觉智能:机器的聆听与表达》(Towar…
一边聊天,一边办事。 从办公协作,走进智能座舱。 在上一篇《qwen-audio-agent架构解析》中,我们主要围绕办公场景介绍了框架。这一次,我们把它带进智能汽车座舱。 我们做了一套可运行的智能座舱示例:接入车控、音乐、导航与天气,让用…
来源丨新智元 谷歌又杀回来了。 今夜,Google DeepMind 一口气放出两个模型——Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking。 官方称它们是谷歌迄今最先进的实时对话模型。…
今天,阶跃正式发布 Step Audio 3 系列模型,包括 StepAudio 3 Realtime、StepAudio 3 ASR、StepAudio 3 TTS、StepAudio 3 Gen 和 StepAudio 3 Music。…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 2…
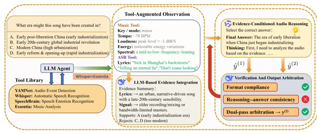
分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。 ⏩1. M…
