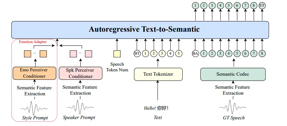
从IndexTTS2看自回归新突破:兼顾表现力与时长的语音合成范式革新

在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregr…
14 0 0

在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregr…
近日,法国AI实验室Kyutai正式开源其高性能TTS语音模型:Kyutai TTS。 它是一款基于Delayed Streams Modeling(DSM)框架的实时文本转语音(TTS)模型,支持流式文本输入、超低延迟和高保真语音生成。…
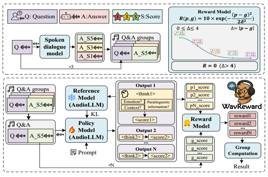
近期,浙江大学联合阿里巴巴通义实验室发表了一篇题为“WavReward: Spoken Dialogue Models With Generalist Reward Evaluators”的论文。该论文提出了一种基于音频理解大模型Qwen2…
分享上海交通大学 X-LANCE 跨媒体语言智能实验室6篇被interspeech2025录用论文。 01、LSCodec: Low-Bitrate and Speaker-Decoupled Discrete Speech Codec
本文由清华大学与腾讯优图实验室合作,研究基于多模态数据的可控语音合成。现有的面部驱动的语音合成方法由于数据质量限制,在鲁棒性和泛化性方面存在缺陷;而文本描述驱动的语音合成方法则存在多样性有限和精细控制不足的问题。另一方面,尽管多模态驱动的语…
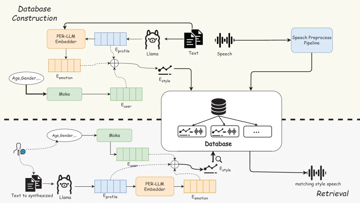
本文由清华大学与腾讯AI Lab合作,研究基于大语言模型与检索增强生成(RAG)技术的自动语音风格匹配文本转语音合成(TTS)系统。当前主流TTS方法虽已实现高保真语音合成,但在语音风格控制方面仍依赖人工设定的提示语,难以自适应待合成文本内…