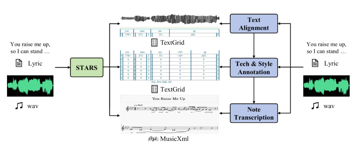
ACL 2025 | STARS: 歌唱转录、对齐与精细化风格标注的统一框架

歌唱语音合成(SVS)的快速发展亟需高质量标注数据集,但传统人工标注成本高昂且效率低下。现有自动歌唱标注(ASA)方法通常仅解决标注流程中的孤立任务。为此,我们提出STARS,首个统一框架,同时解决歌唱转录、歌词对齐与精细化风格标注三大任务…
18 0 0

歌唱语音合成(SVS)的快速发展亟需高质量标注数据集,但传统人工标注成本高昂且效率低下。现有自动歌唱标注(ASA)方法通常仅解决标注流程中的孤立任务。为此,我们提出STARS,首个统一框架,同时解决歌唱转录、歌词对齐与精细化风格标注三大任务…
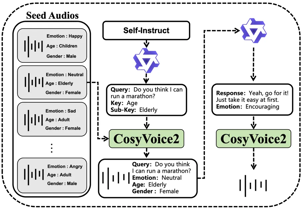
紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…
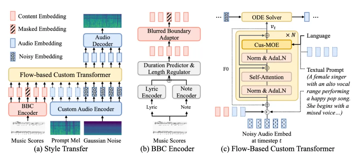
零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…
近年来,神经网络偏置(Deep Biasing)方法在上下文语音识别(Contextual ASR)任务中取得了显著进展,其旨在提升模型对实体名称、技术术语等罕见短语的识别能力。当前主流方法多基于浅融合或神经网络偏置技术,将上下文短语中的子…
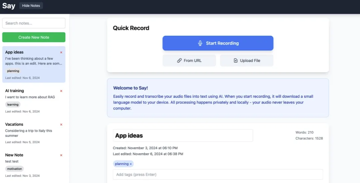
语音转文字(STT)常需云端处理或复杂软件安装,隐私和便利性难以兼得。 Say是一款基于Whisper和Transformers.js的开源浏览器内语音转文字工具,完全本地运行,保护隐私,同时提供实时转录和富文本编辑。 其核心特点包括 •浏…
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
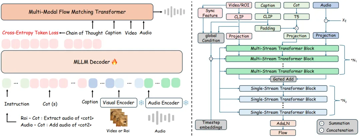
近日,阿里通义实验室开源了旗下首个音频生成模型ThinkSound,该模型首次将CoT(Chain-of-Thought,思维链)应用到音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,Th…
