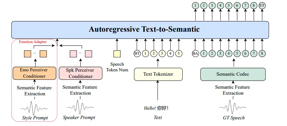
从IndexTTS2看自回归新突破:兼顾表现力与时长的语音合成范式革新

在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregr…
16 0 0

在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregr…
内蒙古大学S2LAB刘瑞教授联合美国约翰霍普金斯大学、美国卡耐基梅隆大学、香港中文大学(深圳)等单位推出了首个面向情感一致性建模的多情感语音编辑数据集——ECD-TSE。该数据集大约90小时,涉及到5种情感,涵盖11个主题内容,总计84,0…
近日,法国AI实验室Kyutai正式开源其高性能TTS语音模型:Kyutai TTS。 它是一款基于Delayed Streams Modeling(DSM)框架的实时文本转语音(TTS)模型,支持流式文本输入、超低延迟和高保真语音生成。…
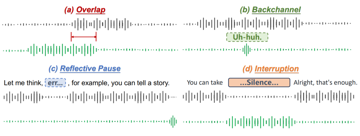
当前,尽管语音基础模型 (Speech Language Model (SLM)) 在模拟人类对话方面取得了显著进展,但如何让机器真正理解并参与到自然、流畅、实时的口语互动中,尤其是在两人对话场景下,仍是一个巨大挑战。现有方法往往难以充分利…
多说话人对话识别是语音处理领域中最具挑战性的问题之一,尤其准确识别重叠语音区域极具挑战。多说话人语音重叠不仅涉及语音片段的重叠,还涉及说话人表征的重叠。有效应对这些挑战对于说话人分离、语音识别以及多说话人对话系统等应用至关重要 。重叠语音检…
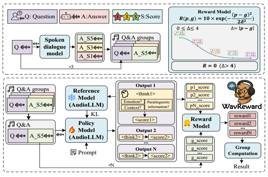
近期,浙江大学联合阿里巴巴通义实验室发表了一篇题为“WavReward: Spoken Dialogue Models With Generalist Reward Evaluators”的论文。该论文提出了一种基于音频理解大模型Qwen2…
分享上海交通大学 X-LANCE 跨媒体语言智能实验室6篇被interspeech2025录用论文。 01、LSCodec: Low-Bitrate and Speaker-Decoupled Discrete Speech Codec
来源丨新智元 智源统一图像生成模型OmniGen2发布后,立刻在AI图像生成领域掀起巨响,多模态技术生态进一步打通。才一周,GitHub星标就已经破了2000,X上的话题浏览数直接破数十万。 刚刚,统一图像生成模型OmniGen2携重大升级…