
声浪

INTERSPEECH2025|Delayed-KD:面向流式语音识别的延迟知识蒸馏CTC方法

流式语音识别(streaming ASR)因其低延迟、高效率的特点,适用在诸多“快速出字”的应用中。当前主流的端到端模型包括 CTC、RNN-T 和基于注意力的编码器-解码器(AED)。其中 CTC 凭借结构简单,在流式场景中被广泛采用。为…
29 1 0
Interspeech2025|U-SAM:统一语音音频音乐理解的音频语言模型
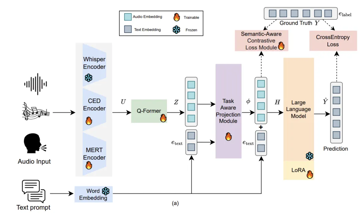
在通用人工智能(AGI)备受瞩目的今天,音频大模型的研究也正快速推进。但相比图文多模态的成熟体系,音频领域仍面临巨大的挑战。不同类型的音频任务——如语音识别、音频事件检测、音乐理解等——往往“各自为政”,难以统一建模。为解决上述问题,西工大…
18 0 0
语音识别中有用的前端算法
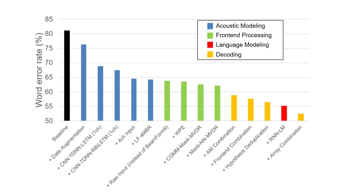
嘈杂环境下的语音识别一直是该领域的一个较为困难的问题,虽然降噪算法可以提升语音质量,但是降噪后的语音对于语音识别的提升并不明显,甚至有可能起到相反的作用。因此在语音识别领域,更多的研究关注在如何让声学模型具有更好的噪声鲁棒性,比如在训练过程…
42 2 0
中文语音领域超强 “活人感” 模型来了,Soul App 升级自研端到端全双工语音通话大模型
近日,社交平台Soul App正式升级自研端到端全双工语音通话大模型,发布SoulX-DuoVoice。新模型摒弃了传统语音交互中依赖的 VAD(话音激活检测)机制与延迟控制逻辑,打破行业中普遍存在的“轮次对话”模式,赋予 AI 自主决策对…
24 0 0
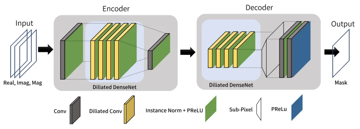
低复杂度降噪技术:助力扫地机器人实现高效实时语音处理
在智能家居设备中,扫地机器人的语音交互功能常受限于其自身运行时产生的高强度噪声,尤其是在信噪比(SNR)低至 - 10 dB 甚至更低的环境下,提取有效语音指令变得极具挑战。 针对这一问题,韩国庆北国立大学与 LG 电子先进机器人实验室的研…
16 0 0
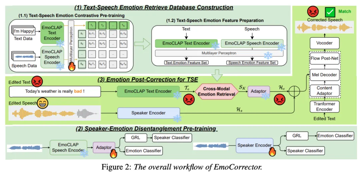
InterSpeech2025丨语音编辑的情感校正数据和方案
本次分享由内蒙古大学刘瑞教授与美国约翰霍普金斯大学Berrak Sisman、美国卡耐基梅隆大学Carlos Busso、香港中文大学(深圳)李海洲教授合作发表于Interspeech 2025的语音编辑情感校正工作《Towards Emo…
17 0 0
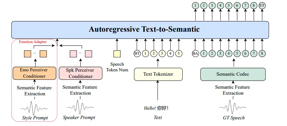
从IndexTTS2看自回归新突破:兼顾表现力与时长的语音合成范式革新
在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregr…
12 0 0
多情感语音编辑数据集ECD-TSE现已开放下载!
内蒙古大学S2LAB刘瑞教授联合美国约翰霍普金斯大学、美国卡耐基梅隆大学、香港中文大学(深圳)等单位推出了首个面向情感一致性建模的多情感语音编辑数据集——ECD-TSE。该数据集大约90小时,涉及到5种情感,涵盖11个主题内容,总计84,0…
14 0 0
开源TTS语音新标杆!Kyutai TTS:350ms延迟碾压全场,词级时间戳重构!
近日,法国AI实验室Kyutai正式开源其高性能TTS语音模型:Kyutai TTS。 它是一款基于Delayed Streams Modeling(DSM)框架的实时文本转语音(TTS)模型,支持流式文本输入、超低延迟和高保真语音生成。…
14 0 0